L’IA produit des hackers à grande échelle : les barrières à l’attaque s’abaissent
Points clés
- L’IA facilite l’analyse des failles et la validation des attaques.
- Puces sécurisées, PIN et conception globale déterminent la sécurité du portefeuille.
- Les failles de composants tiers peuvent ouvrir une attaque via la chaîne d’approvisionnement.
1. Quand les hackers commencent eux aussi à coder avec l’IA
L’IA s’est imposée dans le quotidien. Pour créer un petit outil, beaucoup commencent désormais par décrire leur besoin, demander une première version à l’IA, puis l’exécuter et la corriger. Quelques échanges peuvent suffire à obtenir un programme fonctionnel.
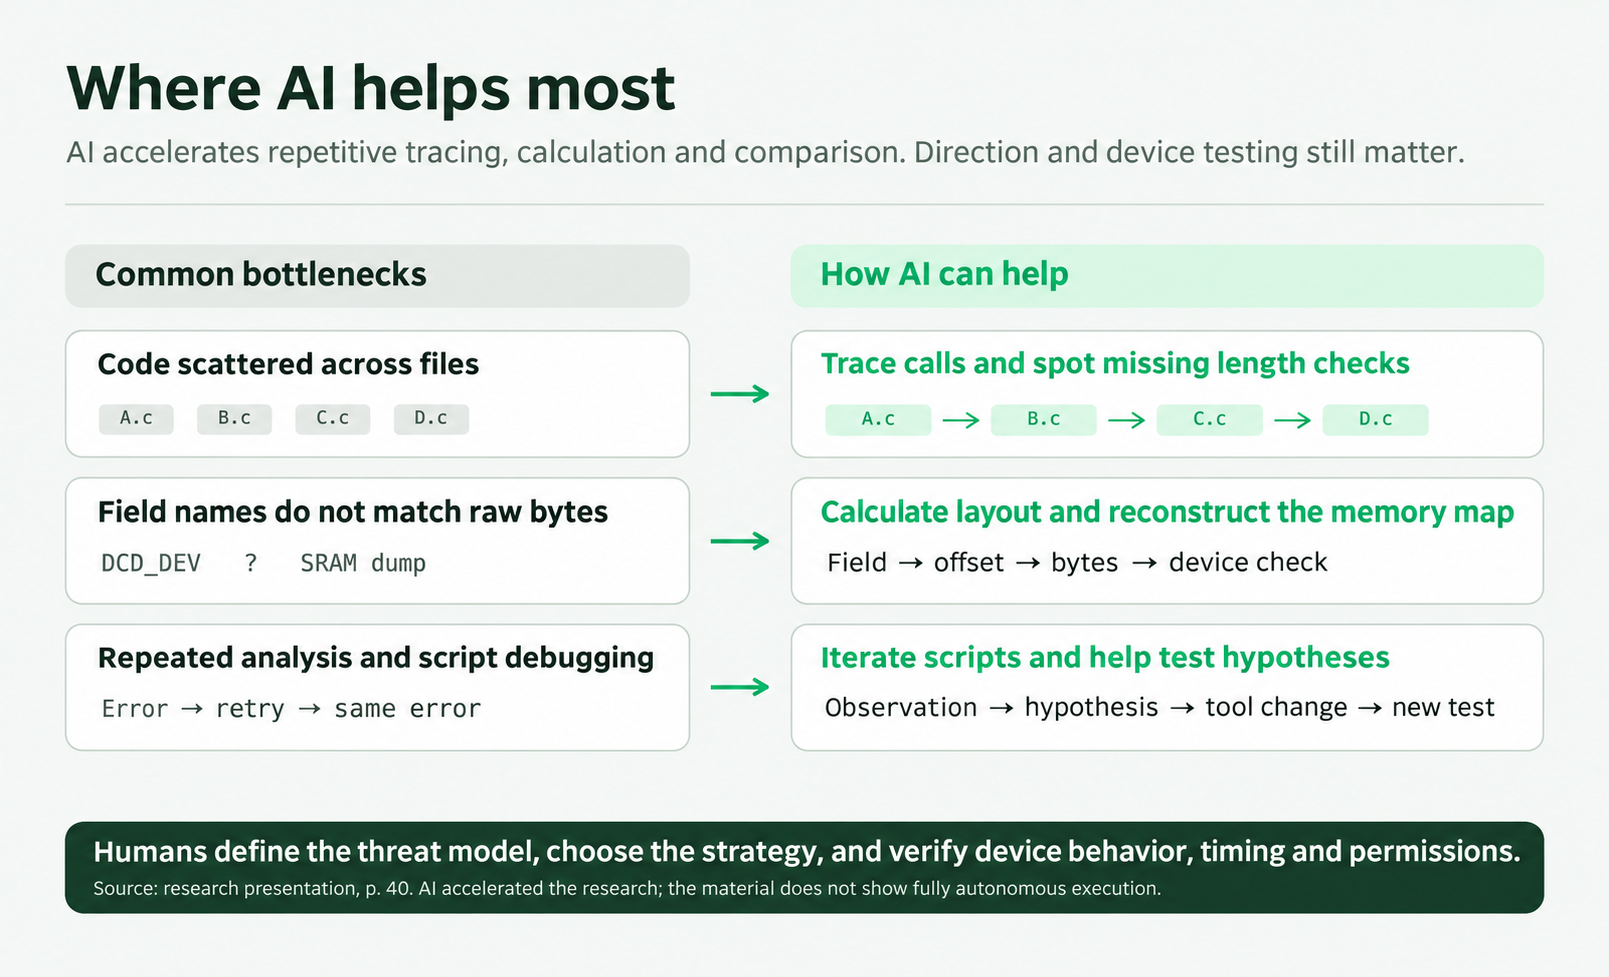
L’IA prend en charge de nombreuses tâches d’analyse de sécurité parmi les plus fatigantes et les plus exigeantes en expérience. Suivre les appels, faire correspondre le code et la mémoire, localiser les erreurs et modifier les outils de test demandait autrefois de longues séries d’interventions manuelles. L’IA accélère ce travail. L’humain fixe toujours la direction et vérifie les résultats, tandis que l’IA assume une part importante de l’analyse et des essais nécessaires pour transformer une idée en démarche vérifiable.
Ces capacités peuvent aussi servir à attaquer. Certains demandent à l’IA d’analyser un projet et d’ajouter des fonctionnalités ; d’autres lui font suivre les appels, lire la mémoire et modifier des outils pour trouver une porte d’entrée dans un réseau ou un appareil. Les tâches se ressemblent ; leur finalité dépend de la personne qui les demande.
C’est ainsi que l’IA abaisse concrètement les barrières à l’attaque. Des tâches répétitives, mais exigeant une expertise spécialisée, bloquaient auparavant de nombreux débutants. Avec quelques connaissances en programmation et en matériel, ils peuvent maintenant poursuivre l’exploration à partir des analyses de l’IA. Même sans savoir coder, des escrocs peuvent s’en servir pour créer des sites de phishing convaincants.
Nous nous appuierons sur une étude de l’équipe OneKey Anzen pour montrer le rôle de l’IA dans l’analyse d’attaques matérielles : évaluer un portefeuille doté de trois éléments sécurisés et examiner jusqu’où un attaquant peut progresser avec cette assistance.
Ce cas est représentatif : il commence par une faille USB, un problème d’implémentation qui peut aussi toucher d’autres appareils. Un portefeuille matériel possède une conception dédiée à la protection des actifs numériques. Suivre l’analyse étape par étape aide à examiner ses frontières de sécurité et à comprendre ce que recouvre une attaque assistée par l’IA.
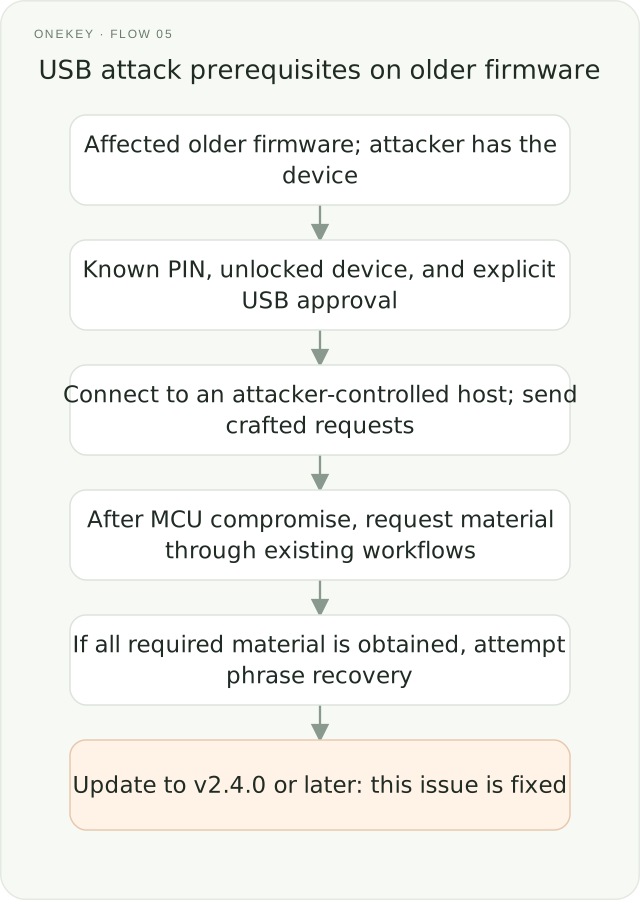
Périmètre et correction : cet article revient sur un audit conjoint de OneKey Anzen et Keystone. Le problème concernait d’anciens firmwares du Keystone 3 Pro intégrant ce SDK USB et a été corrigé dans la version v2.4.0, publiée le 1er avril 2026. L’avis officiel exige plusieurs conditions : possession physique de l’appareil, connaissance du bon PIN, appareil déverrouillé, autorisation de la connexion USB et ordinateur contrôlé par l’attaquant. Lors de la publication de l’avis, aucune des deux équipes n’avait trouvé de preuve d’exploitation contre des utilisateurs. L’analyse ne signifie ni que les versions actuelles restent vulnérables, ni que la recharge seule suffit à déclencher une attaque. Étude officielle et mise à jour de sécurité
2. Qu’est-ce qu’un portefeuille matériel ?
Un bref rappel sur la blockchain permet de mieux comprendre son rôle.
Une blockchain ressemble à un registre entretenu par des milliers d’ordinateurs, autrement dit un réseau de serveurs distribués. Les cryptomonnaies comme le bitcoin y sont inscrites. Comme pour un actif nominatif, la propriété est représentée par les enregistrements plutôt que par de l’argent conservé physiquement dans la main.
Comment prouver qu’un actif vous appartient ? La phrase de récupération donne accès aux clés qui permettent d’en autoriser l’usage. On peut comparer ces clés à un sceau électronique : celui qui peut apposer le sceau peut autoriser des transactions. Contrairement à une carte bancaire, ce sceau ne peut pas simplement être déclaré perdu et remplacé. Une personne qui obtient les informations de récupération nécessaires peut contrôler les actifs correspondants.
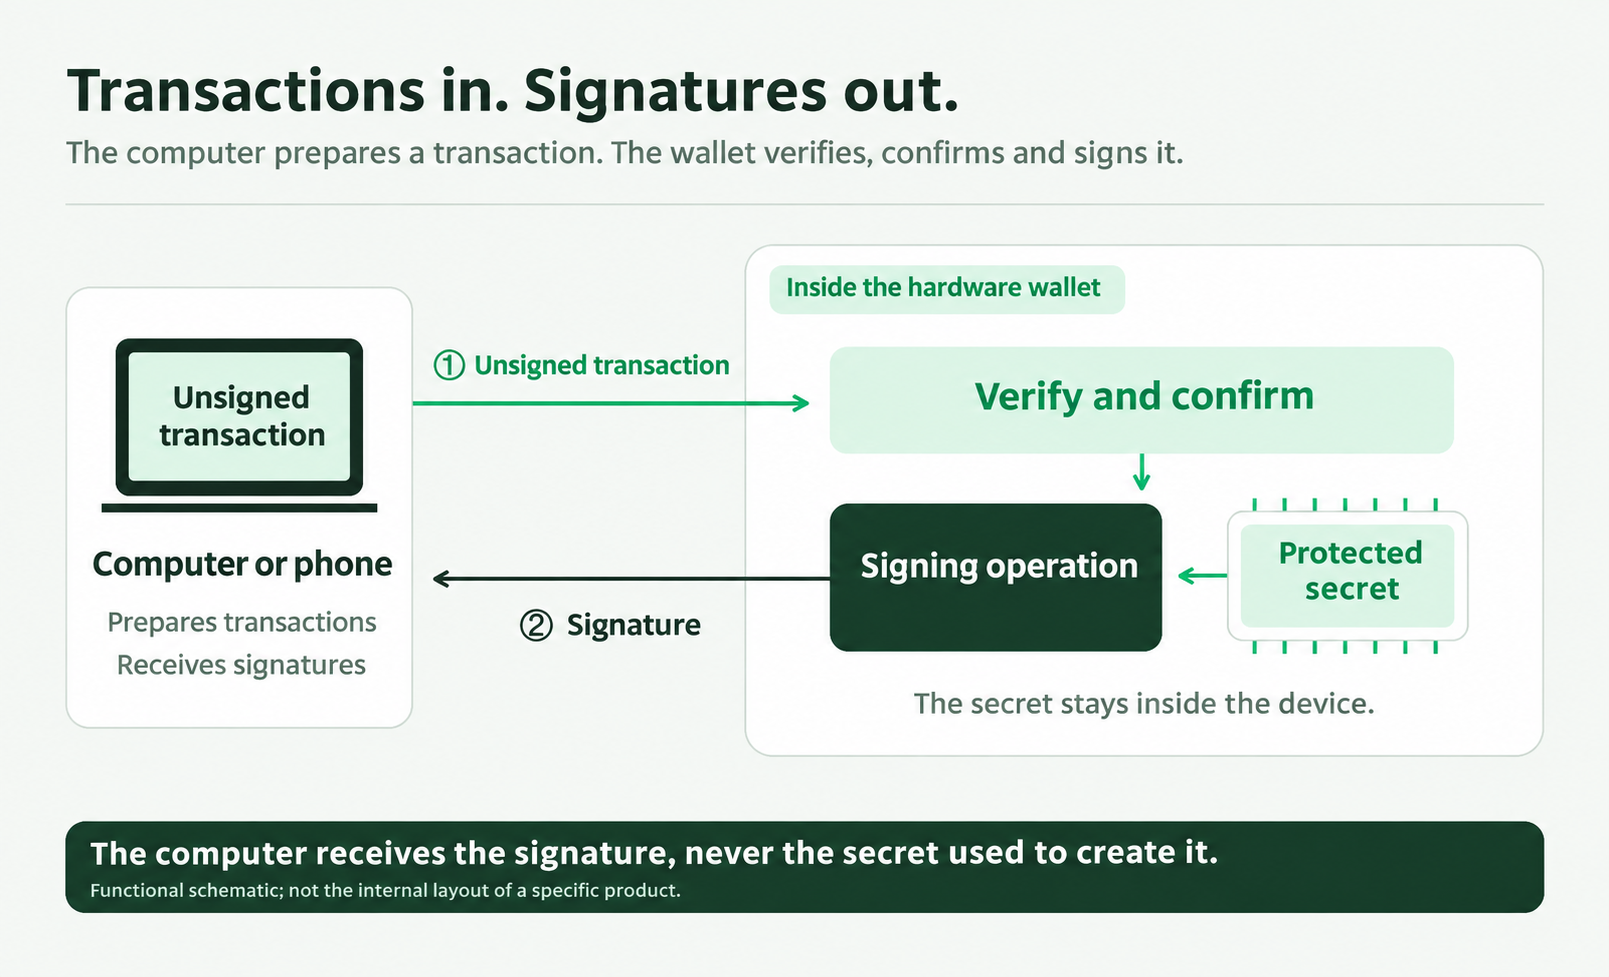
Le portefeuille matériel protège ce sceau. Un contrôleur principal communique avec l’ordinateur et coordonne les composants ; les éléments sécurisés (SE) conservent les secrets et vérifient les conditions d’accès. L’ordinateur prépare une transaction, puis l’appareil la signe en interne et renvoie le résultat. L’ordinateur reçoit le document signé, pas le sceau lui-même.
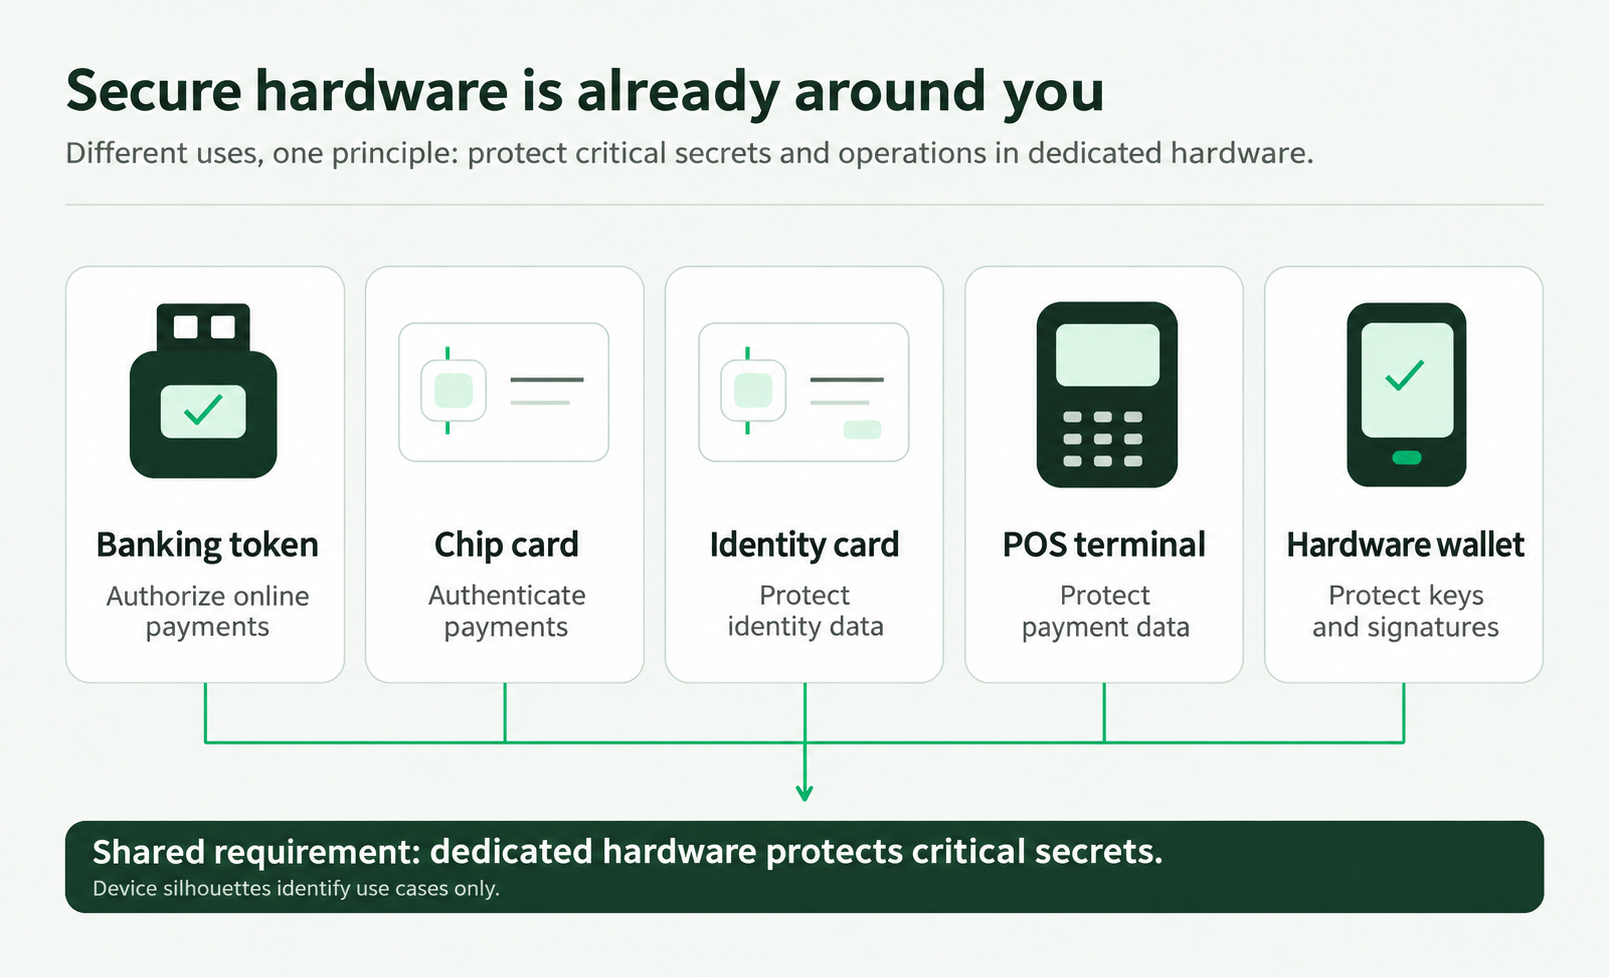
Le même principe est utilisé dans les jetons bancaires, les cartes de paiement et les cartes d’identité : un matériel spécialisé conserve les secrets et réalise les opérations sensibles en interne. Le portefeuille matériel l’applique aux actifs numériques. Jetons bancaires, puces de paiement et d’identité, puces de cartes d’identité
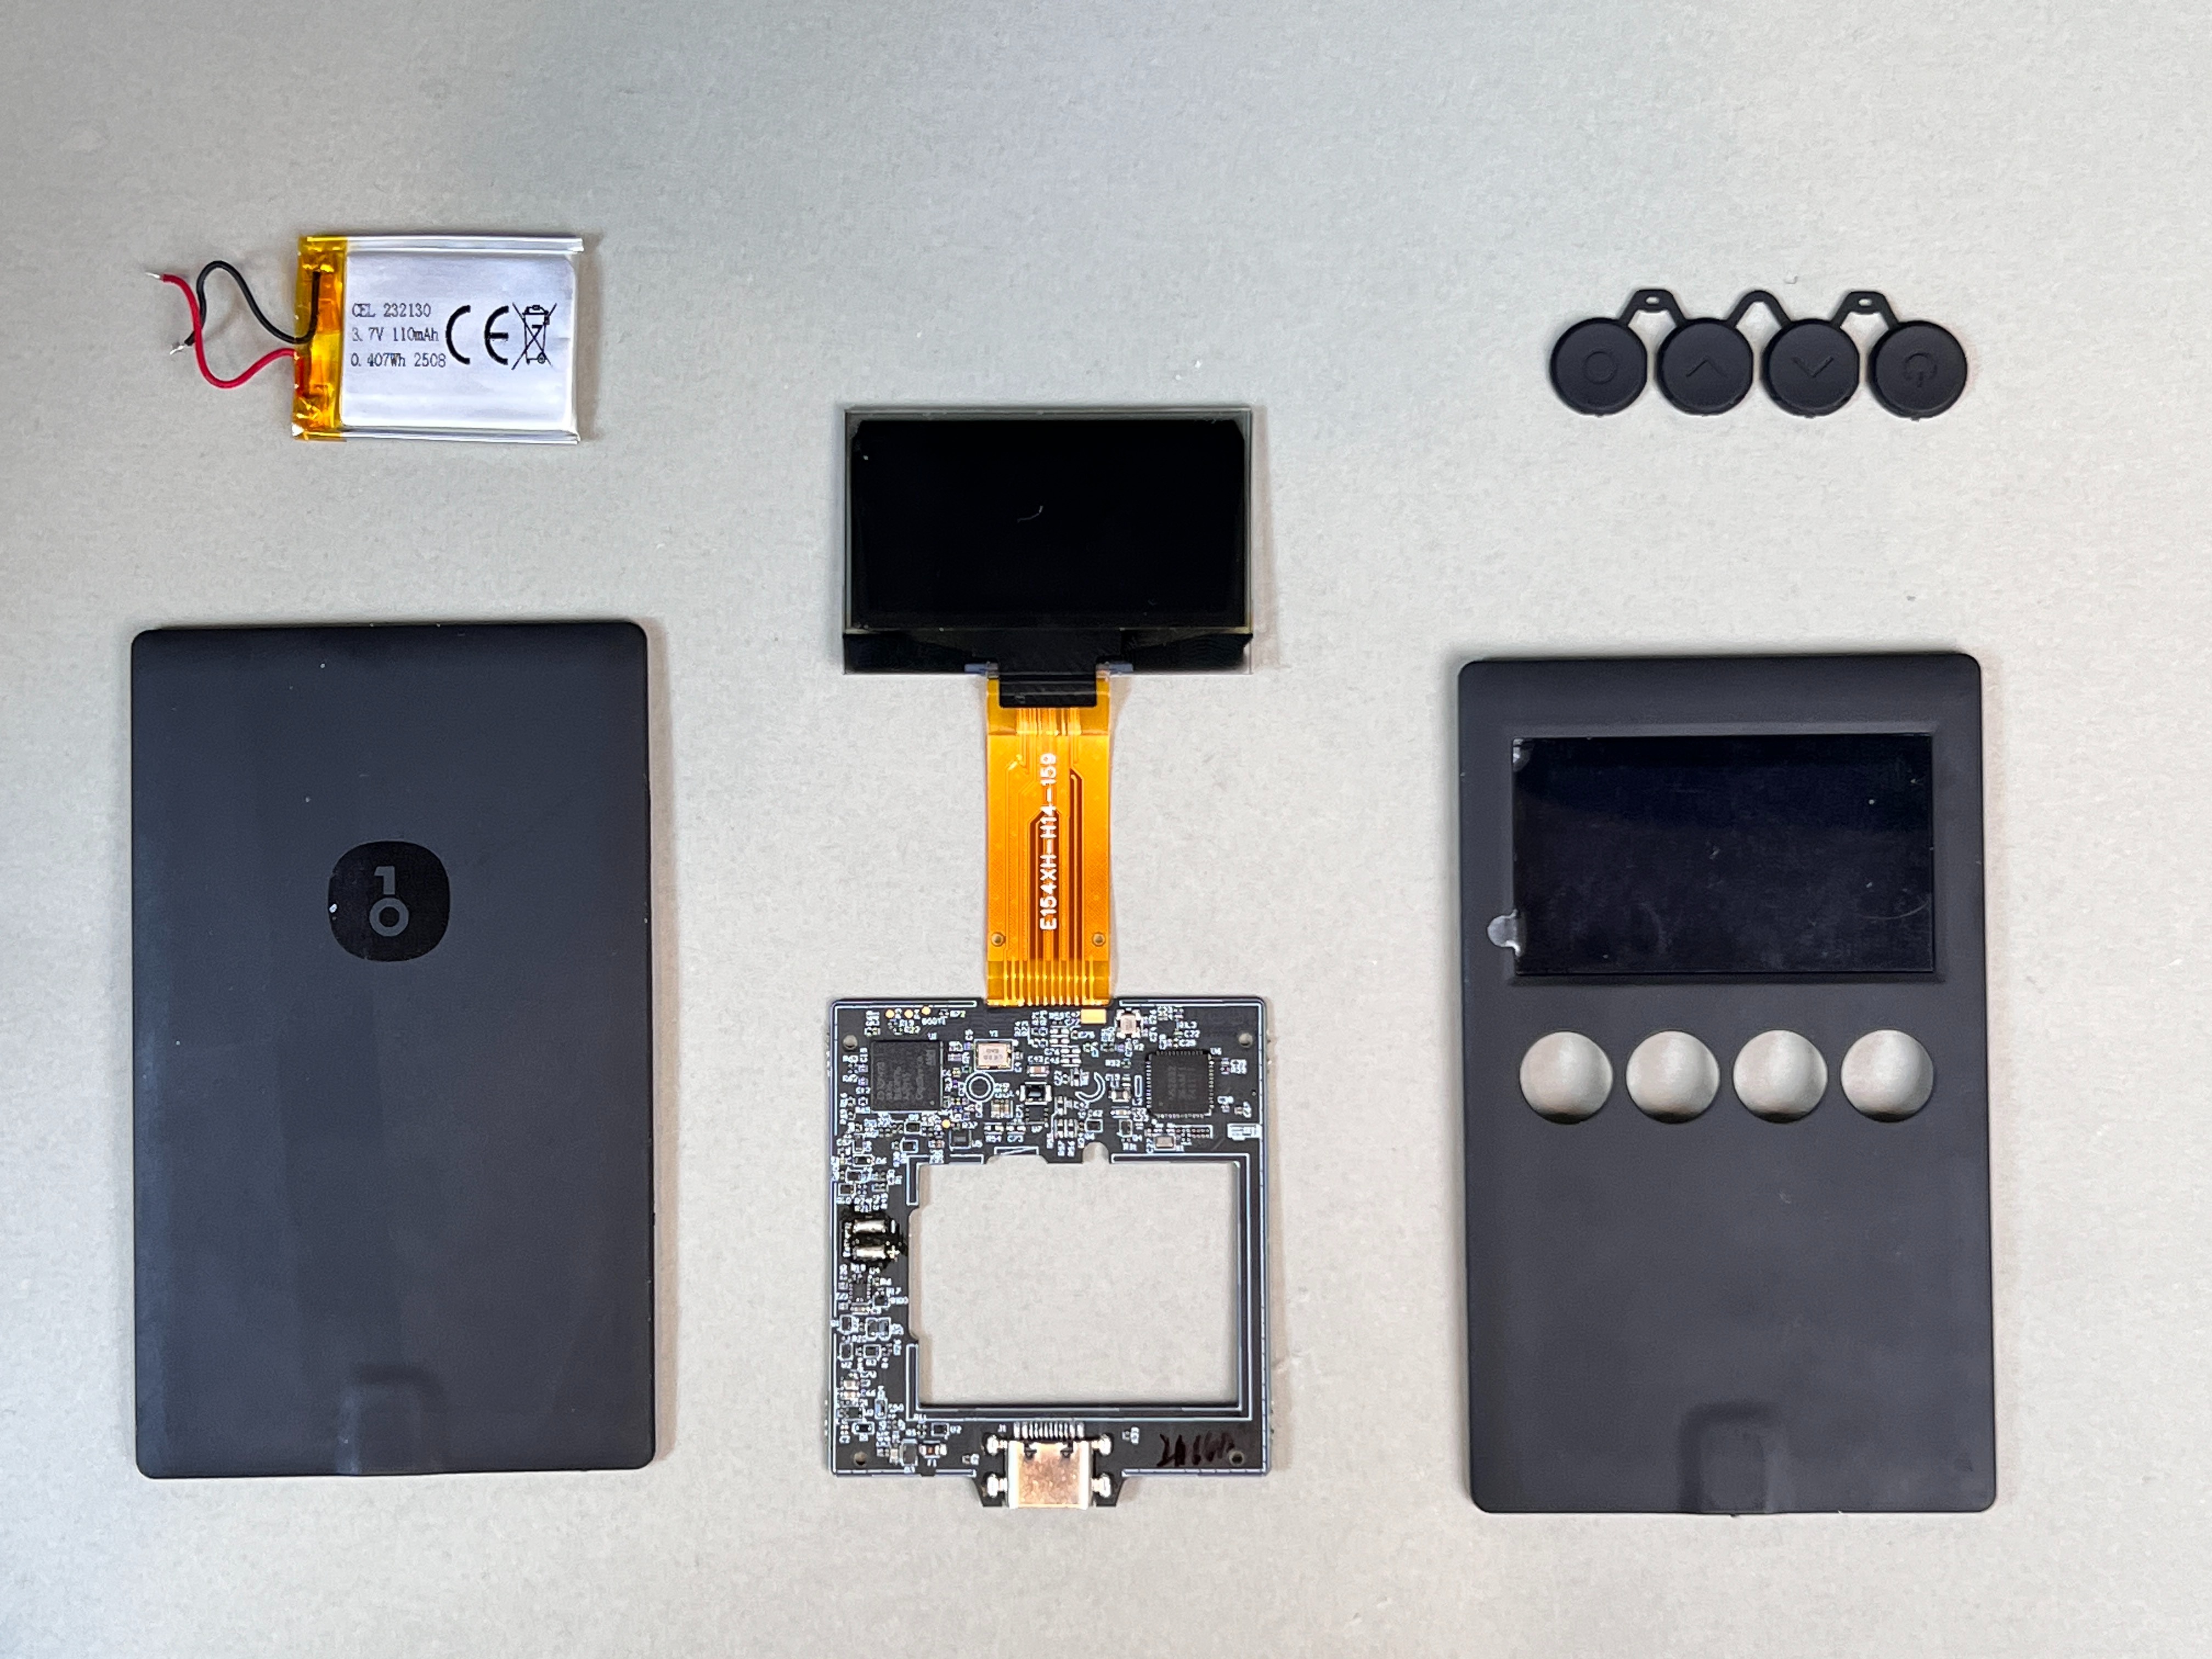
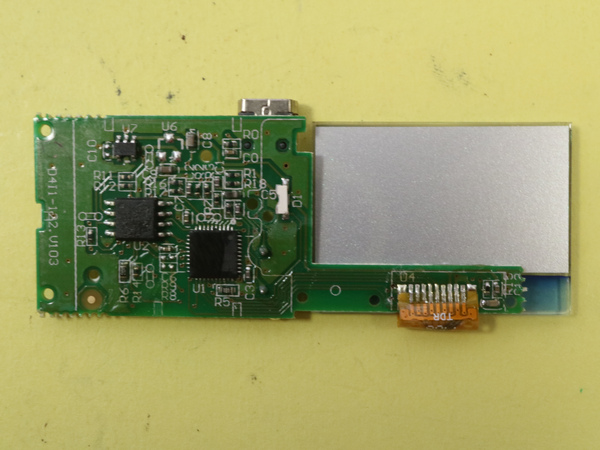
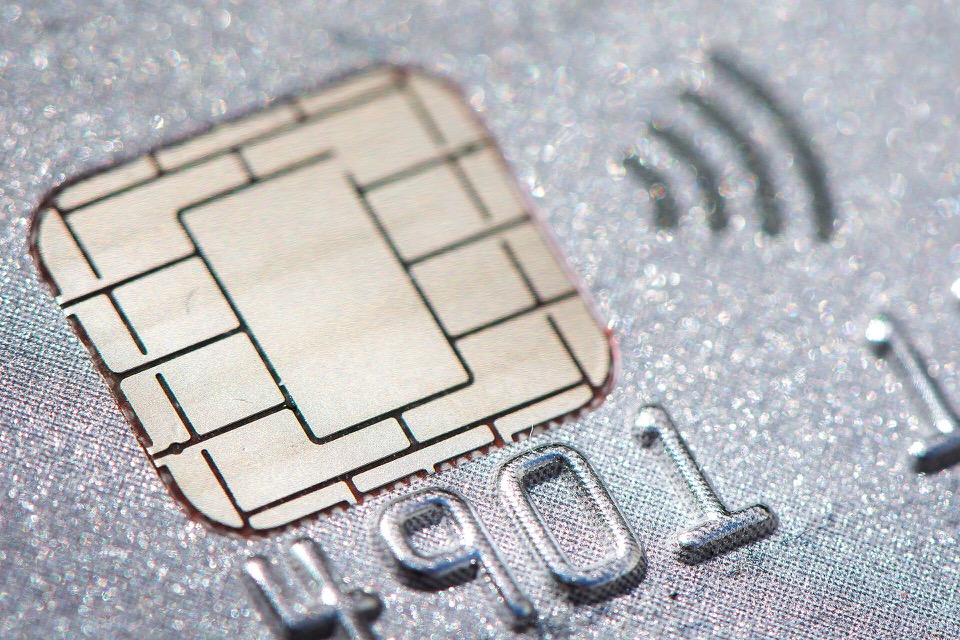
Exemples physiques | L’appareil OneKey illustre la structure d’un portefeuille matériel. Photos : démontage officiel OneKey, démontage BugWorkShop et gros plan de carte bancaire par kuhnmi (CC BY 2.0, images redimensionnées).
Les portefeuilles matériels constituent donc un terrain de recherche utile : leurs faiblesses peuvent aussi exister dans d’autres équipements de sécurité. Leur rôle potentiel dépasse d’ailleurs la simple conservation de ce sceau électronique.
À mesure que l’IA effectue des paiements, signe des demandes et agit pour le compte des utilisateurs, la gestion des identités et des permissions devient essentielle. Une approche consiste à regrouper les autorisations derrière un point de validation unique, où l’humain décide des opérations admises. Un portefeuille matériel pourrait jouer ce rôle.
Suivons maintenant l’analyse d’un portefeuille matériel pour voir où l’IA intervient à chaque étape.
3. Comment l’IA accompagne l’analyse d’un portefeuille matériel
1. Tout commence par un bug courant
Ce cas provient d’un audit conjoint avec un autre fabricant de portefeuilles. L’objectif était d’évaluer la sécurité avec l’aide de l’IA et de déterminer jusqu’où un attaquant pouvait avancer par une interface d’usage normal. Restait à choisir le point de départ.
L’appareil est présenté comme un portefeuille froid « air-gapped » : sans Bluetooth ni Wi-Fi, il échange les transactions via une caméra, une carte SD ou une connexion USB.
Il contient trois éléments sécurisés. Les données nécessaires à la récupération sont réparties entre plusieurs composants, et le contrôleur principal transmet les requêtes et les réponses. Ces informations sont publiques ; un débutant peut demander à l’IA de l’aider à lire la documentation et le firmware open source.
Nous avons limité les points d’entrée à l’USB et à la carte SD. Cette voie de recherche utilisait les interfaces normales sans ouvrir le boîtier : sondes, câblage ajouté, injection de fautes, canaux auxiliaires, ports JTAG/SWD et attaques du bootloader en étaient exclus. L’USB reste une connexion utilisée lors de la signature ou de la recharge.
La direction était claire : examiner si l’USB pouvait affecter le contrôleur principal, lui faire exécuter du code fourni par l’attaquant, puis réutiliser les procédures de l’appareil pour demander les données nécessaires. Les piles USB constituent depuis longtemps un terrain fréquent de bugs de sûreté mémoire.
Cette voie concerne les anciens firmwares affectés et reste soumise aux conditions officielles rappelées plus haut. Le déverrouillage et l’approbation de la connexion USB sont indispensables ; brancher un câble ou recharger ne suffit pas à ouvrir le canal d’attaque.
La pile USB implémente les règles de dialogue entre un ordinateur et un appareil. Le fabricant de puces transforme la norme en code, distribué dans un kit de développement logiciel (SDK), puis le fabricant de l’appareil l’intègre à son produit. La pile est la partie qui reçoit et traite les messages USB.
Une interface standard ne garantit ni une qualité d’implémentation ni une maintenance uniformes. Certains codes sont réutilisés pendant des années sans nouvel examen. Une seule faiblesse dans ces détails peut permettre de déclencher un problème à partir d’un champ contrôlé par l’hôte.
La pile comporte des descripteurs, des requêtes de contrôle, des commandes de classe et des points de terminaison de données. Les entrées sont nombreuses : il faut cibler la recherche.
Nous avons privilégié les champs de longueur. Contrôlables depuis l’extérieur, ils déterminent combien d’octets l’appareil lit ou écrit et comment il organise le stockage des données reçues.
Faire confiance à une longueur fournie par l’ordinateur peut provoquer un accès hors limites. Si un tampon de 8 octets reçoit une demande d’écriture de 1 000 octets et que le programme l’exécute, le surplus écrase la mémoire voisine. Cela peut ouvrir la voie à du code injecté. Il faut donc vérifier que chaque longueur est comparée à la capacité disponible avant l’accès.
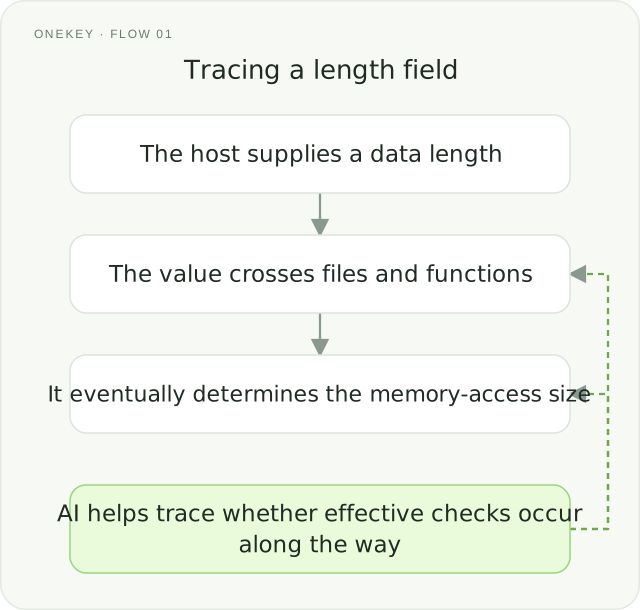
Les longueurs circulent si souvent que chaque couche peut supposer qu’une couche précédente les a déjà contrôlées. Une seule supposition erronée suffit parfois à supprimer toute vérification effective.
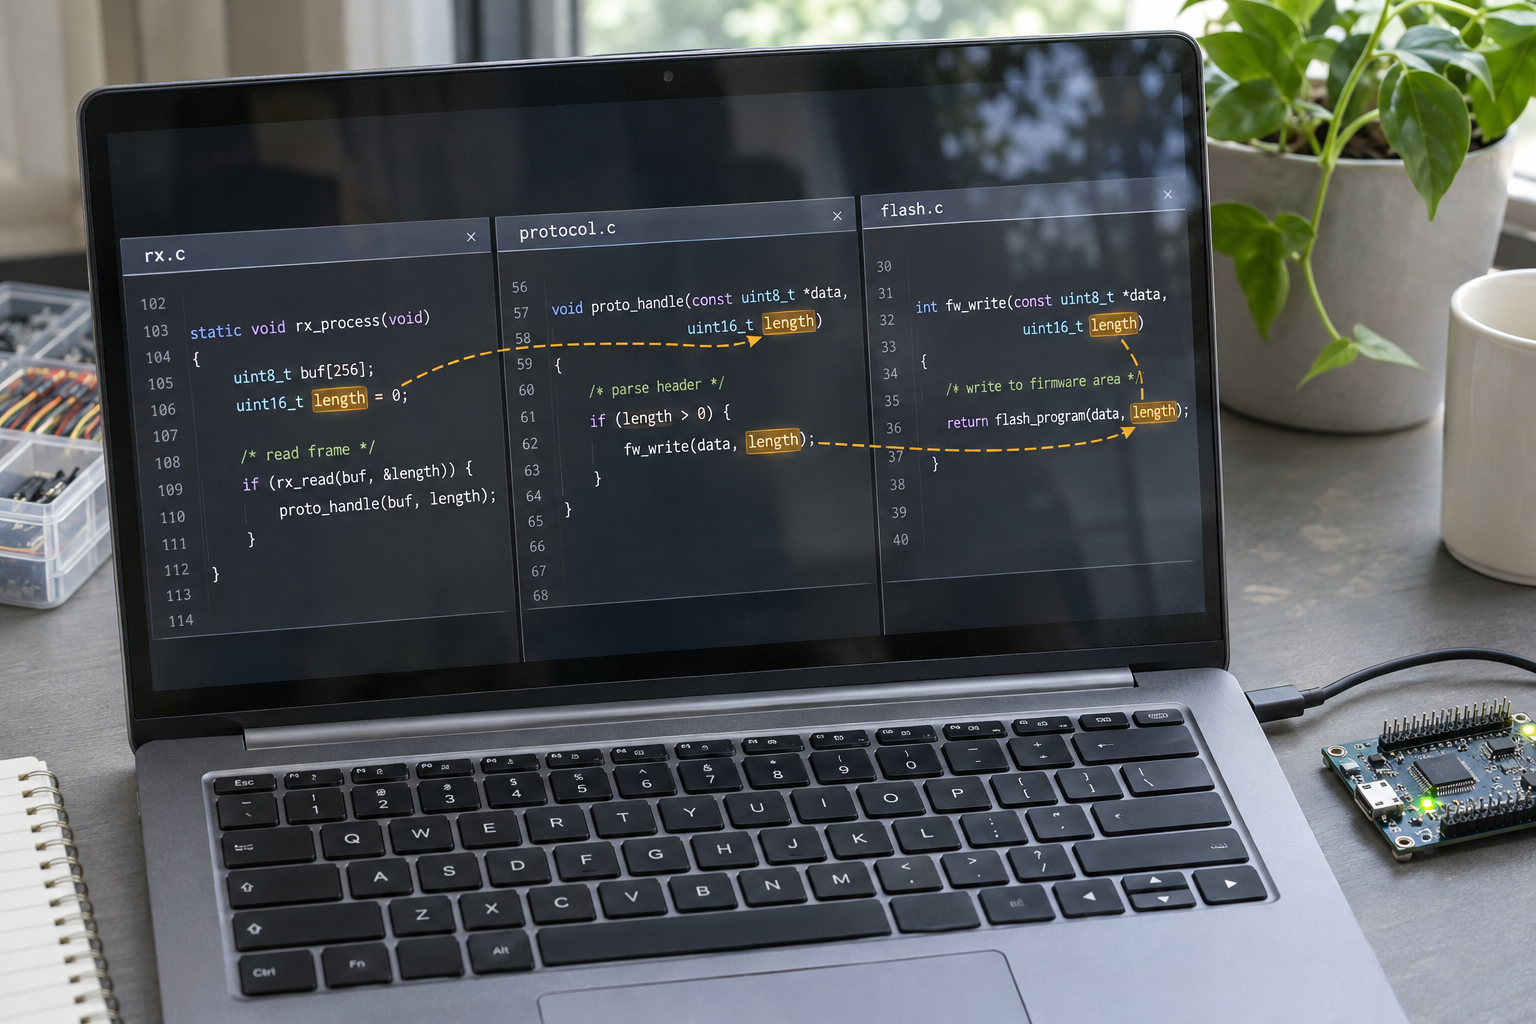
La plupart des chemins possèdent des contrôles valides ; la difficulté consiste à trouver l’exception. La méthode classique suit la longueur depuis son entrée, fonction après fonction et fichier après fichier, en notant son origine, ses transformations, son utilisation finale et les validations rencontrées.
Une fonction isolée peut seulement recevoir une longueur et la transmettre. La chaîne complète peut traverser une dizaine de fonctions et plusieurs fichiers, avec des troncatures, des décalages, un stockage dans une structure puis une nouvelle lecture.
Au troisième fichier, il devient facile d’oublier l’origine du nombre. Plusieurs champs exigent ce même suivi complet. L’expérience guide la recherche, et l’attention soutenue permet de vérifier les détails : les deux sont nécessaires.
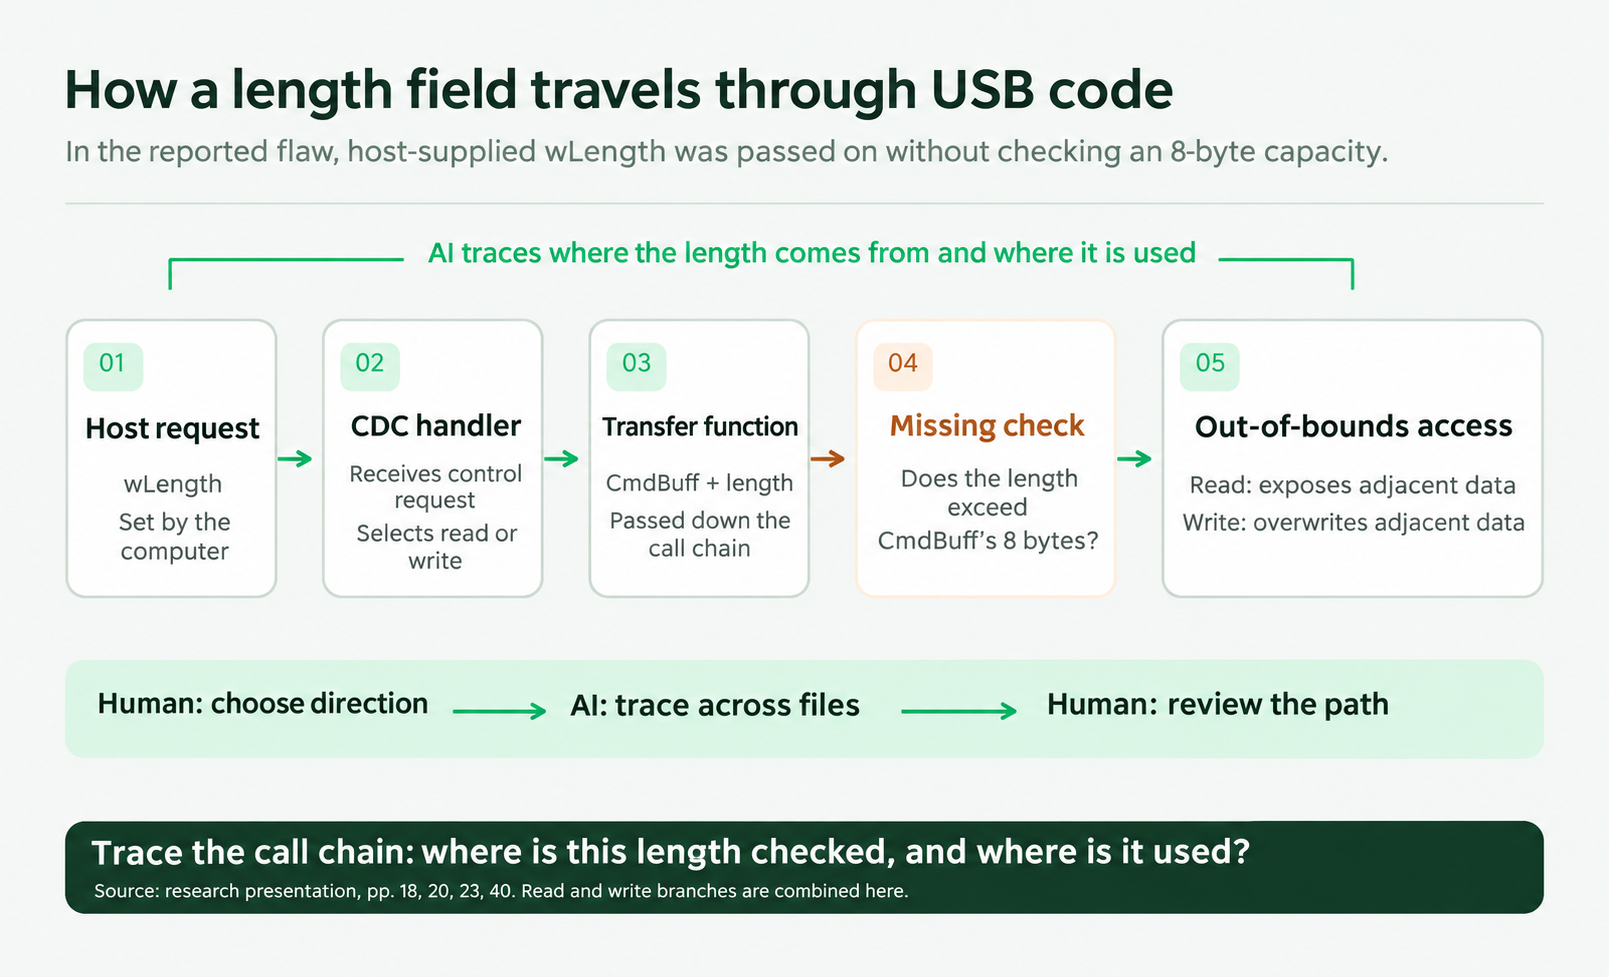
L’IA peut organiser ces informations, suivre les champs dans les appels, cartographier le chemin entre l’entrée et l’accès mémoire, puis aider à repérer les endroits suspects. Le chercheur vérifie ensuite l’efficacité des contrôles et la reproductibilité du problème.
La faille trouvée était une écriture hors limites : le tampon ne contenait que 8 octets, mais la longueur reçue de l’extérieur n’était pas correctement limitée. Les données supplémentaires atteignaient la mémoire voisine. Le défaut se trouvait dans un composant USB tiers intégré au portefeuille.
Pourquoi l’accès continue-t-il au-delà des 8 octets ? Ils ne forment qu’une petite région au milieu d’autres données. Le processeur ne connaît pas automatiquement la longueur d’un tableau déclaré dans le code source.
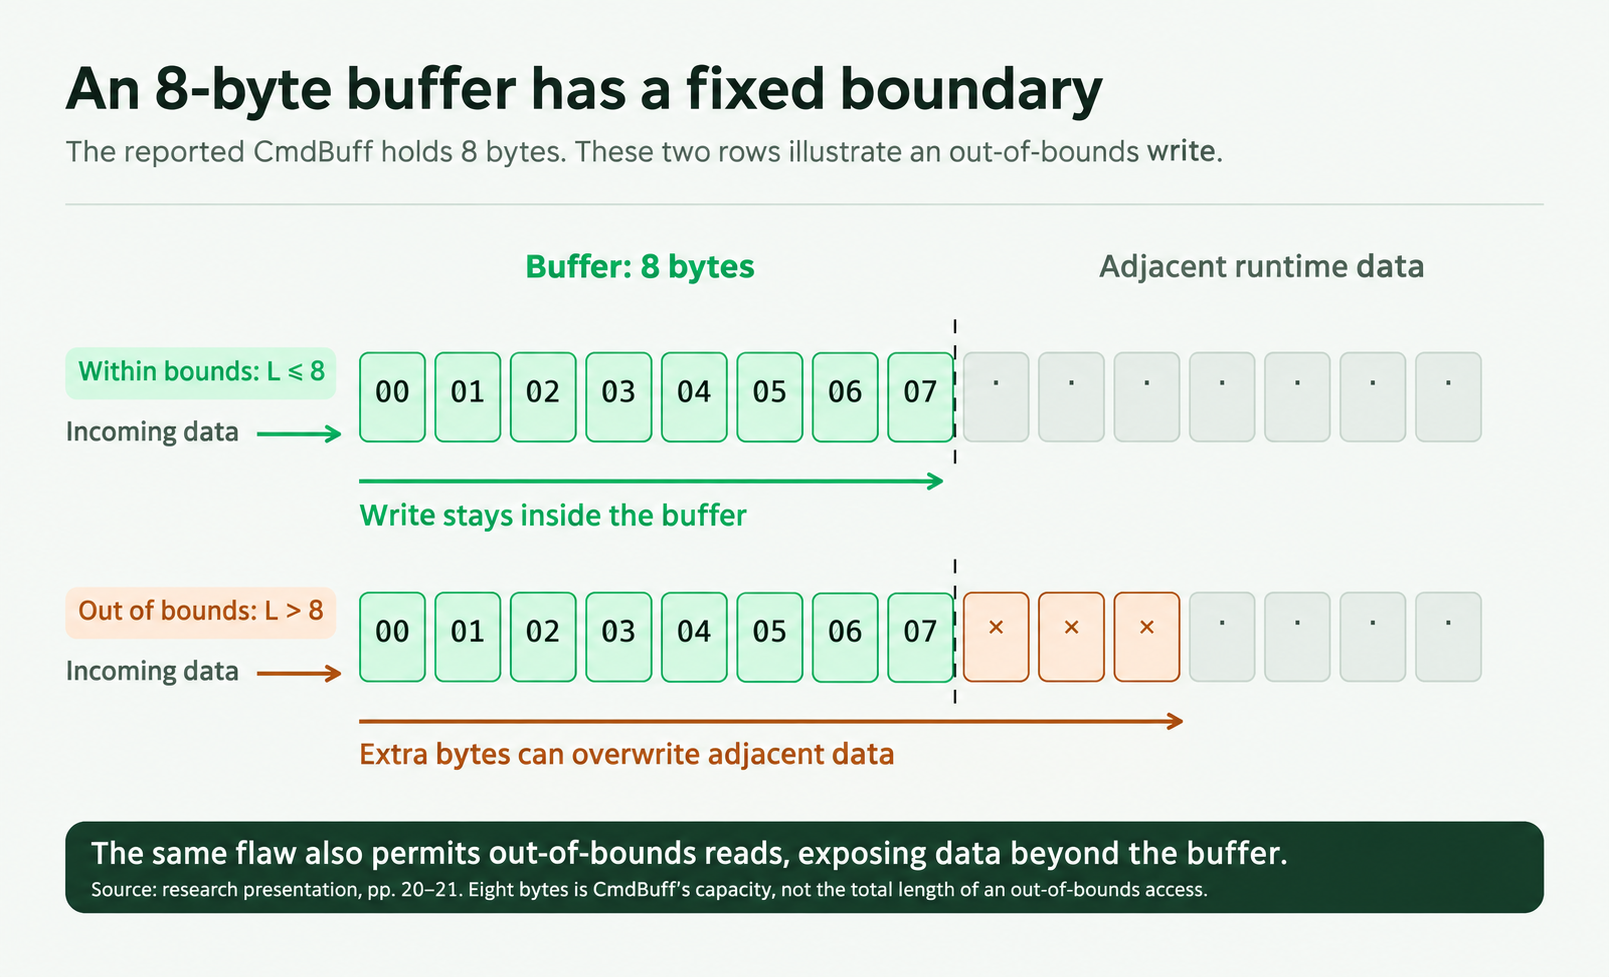
Un tampon est défini par une adresse de départ et une longueur. Une fois sa limite franchie, l’accès peut continuer si la mémoire voisine est accessible. Une lecture hors limites peut divulguer des données ; une écriture peut les modifier. Un simple champ de longueur peut ainsi affecter l’état interne de l’appareil.
Franchir cette limite n’est qu’un début. Il faut encore déterminer quelles données maintiennent la communication, lesquelles influencent l’exécution et ce que chaque modification produit. Entrer dans une pièce ne révèle pas le fonctionnement de tous ses mécanismes.
2. Que permet réellement cette faille ?
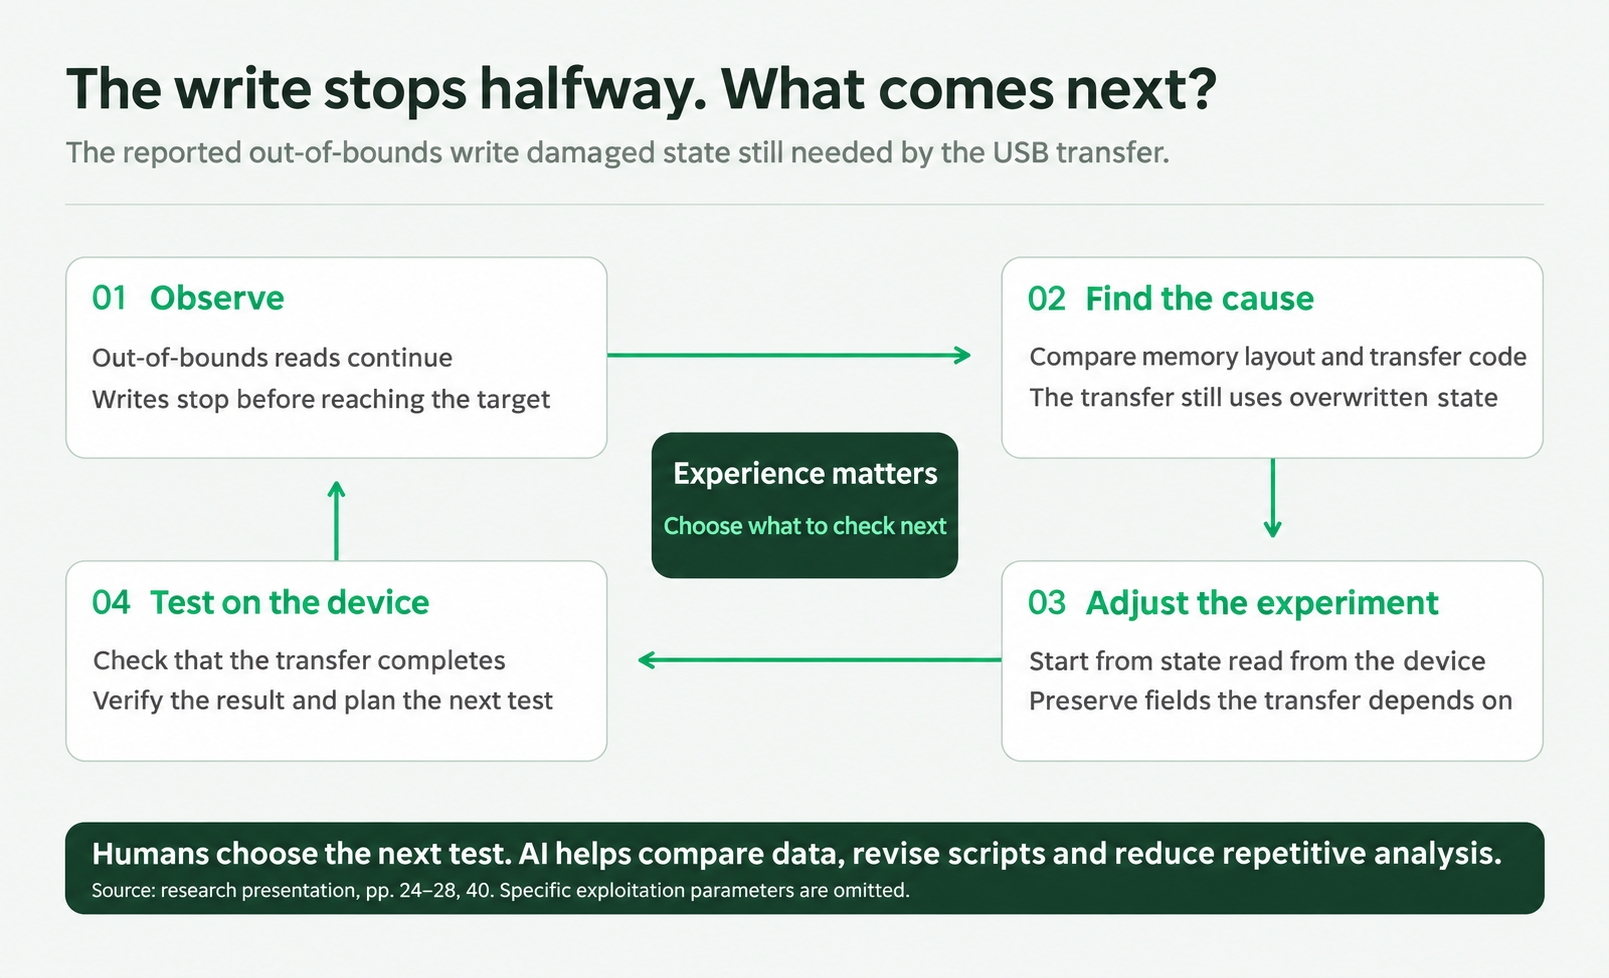
Nous avons commencé à tester ses effets. La première écriture a immédiatement interrompu la connexion USB.
Cette coupure empêchait de poursuivre, mais révélait aussi un indice : le tampon devait être proche d’un état nécessaire au fonctionnement de l’USB, précisément endommagé par l’écrasement.
Les données du programme occupent des positions voisines, selon une disposition déterminée à la compilation. Après les 8 octets de buffer[8] peuvent se trouver l’état usb_state, la longueur reçue rx_len ou un pointeur de rappel.
Imaginez une rangée de casiers. Le développeur leur donne des noms, mais le processeur accède à des adresses. Une écriture continue de 1 000 octets ne s’arrête pas automatiquement à chaque frontière de variable et peut écraser des données indispensables.
Pour stabiliser l’USB, il faut préserver les états critiques : ne modifier que les zones sans effet sur le fonctionnement normal, ou réécrire les valeurs importantes à l’identique en traversant la mémoire.
Une modification précise exige de faire correspondre le code source et la mémoire réelle. Le code décrit les variables et les structures ; un dump mémoire fournit surtout des adresses et des valeurs. Leur correspondance doit être vérifiée champ par champ.
C’est l’une des tâches les plus longues et les plus exigeantes en expérience. Le chercheur déduit les positions à partir des types, des longueurs et de l’alignement, puis les compare à l’appareil. Un décalage incorrect peut fausser toute la suite. Pour un débutant, comprendre la disposition d’une structure constitue déjà un obstacle.
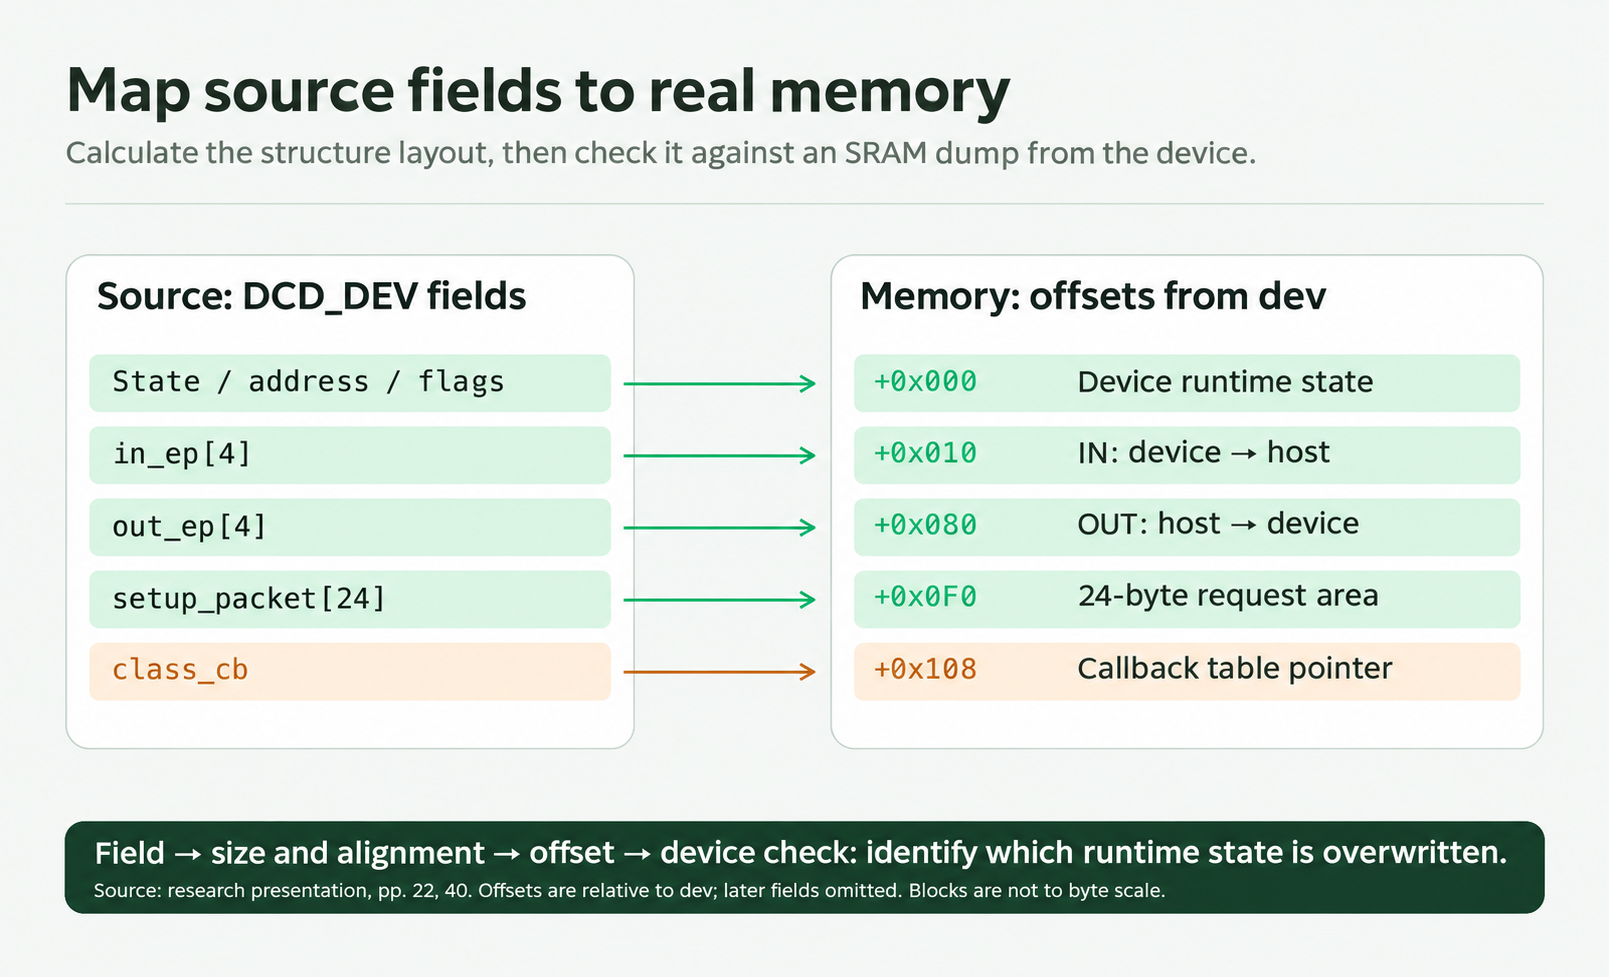
L’IA peut aider à répéter ces comparaisons : le code est du texte et la mémoire peut être représentée en hexadécimal, ce qui permet de les analyser ensemble. Elle aide aussi à modifier les outils de test, tandis que le chercheur choisit la suite à partir des résultats. Un agent peut enchaîner analyses et appels d’outils pour affiner progressivement la cartographie.
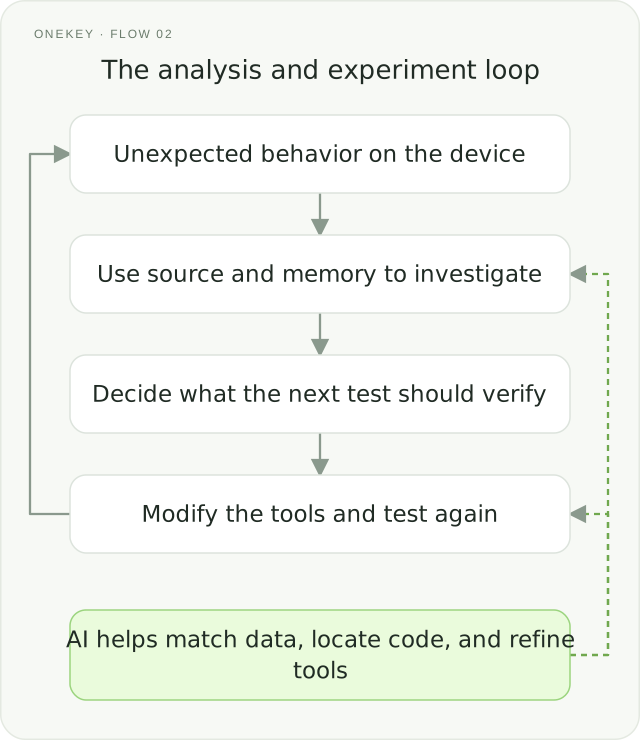
Après plusieurs expériences, nous avons trouvé une écriture qui modifiait la région visée tout en préservant les données nécessaires au fonctionnement, maintenant ainsi la connexion.
L’étape suivante consistait à rediriger l’exécution vers le code injecté. Un pointeur de fonction est une cible naturelle : comme une entrée dans un programme de spectacle, il indique quelle fonction doit être appelée. Le modifier peut changer le chemin d’exécution.
Les appareils prévoient normalement une protection : certaines régions mémoire sont déclarées inscriptibles mais non exécutables, et une unité matérielle contrôle les permissions.
Lorsque cette protection fonctionne, le processeur refuse d’exécuter le code injecté, même si le pointeur le désigne. L’appareil étudié comportait une erreur de configuration de son unité de protection mémoire (MPU), laissant une ouverture à cette étape.
Si le pointeur peut être modifié et le code injecté exécuté, l’attaquant obtient l’exécution de code sur le contrôleur. La signature du firmware vérifie le code chargé au démarrage ; les modifications mémoire pendant son exécution nécessitent également des protections à l’exécution.
La possibilité d’aller du contrôle du MCU aux secrets de récupération dépend des frontières d’autorisation de l’ensemble de la conception de sécurité.
3. Pourquoi contrôler le MCU ne révèle-t-il pas immédiatement la phrase ?
Une suite évidente consiste à lire la mémoire pour y chercher la phrase de récupération.
Les portefeuilles matériels conservent les données de récupération chiffrées, les déchiffrent temporairement pour certaines opérations et les effacent ensuite de la mémoire de travail. Lire la mémoire ne donne donc pas automatiquement le texte clair : il faut d’abord localiser les données chiffrées.
Le firmware open source fournit les indices. Avec l’aide de l’IA, on identifie les données chiffrées dans les pages d’un élément sécurisé : les 16 premiers octets de Page 0 contiennent l’IV, tandis que Page 1 contient le texte chiffré.
Il faut ensuite associer les champs du code aux données réelles : quelle adresse correspond à chaque champ, quels octets constituent l’IV et lesquels constituent le texte chiffré.
L’IA aide à nouveau à effectuer cette correspondance fastidieuse et à localiser les données pertinentes.
Deux voies restent alors possibles : casser le chiffrement ou réutiliser la procédure de déchiffrement de l’appareil.
Première voie : casser directement le chiffrement
Le chiffrement ressemble à une serrure : avec la clé, fermer et ouvrir sont simples ; sans elle, le texte chiffré doit rester de peu d’utilité.
Notons E les données d’origine, C le texte chiffré et K la clé de chiffrement.
Leur relation s’écrit :
Chiffrer E avec K produit C ; déchiffrer avec la même clé restitue E. L’attaque envisagée consisterait à retrouver E sans K. Un algorithme sûr vise précisément à rendre cela irréalisable en pratique par le calcul.
Comment mesurer cette sécurité ? La cryptographie propose un cadre précis.
Choisissez deux textes clairs E₀ et E₁. L’ordinateur en sélectionne un au hasard, le chiffre avec K et vous montre C. Pouvez-vous identifier le texte choisi ?
Un chiffrement sûr doit satisfaire la condition suivante :
Pr[bonne réponse] désigne la probabilité de répondre correctement ; ½ correspond au hasard. Les barres verticales prennent la valeur absolue de l’écart. C’est l’idée de sécurité sémantique.
Après avoir choisi deux textes et reçu le chiffrement de l’un d’eux, votre précision doit rester proche du hasard. Même des textes très différents, comme 00000000 et 11111111, ne doivent pas laisser d’indice fiable dans le résultat. Voilà le principe central : le chiffrement ne doit pas révéler quelle réponse est la bonne.
Deux possibilités donnent une probabilité de référence de ½. Avec quatre possibilités, elle vaut un quart ; avec davantage, elle diminue encore. L’essentiel est que le texte chiffré ne donne pas d’avantage significatif par rapport au hasard.
Sans raccourci mathématique utile, il faut essayer les clés candidates. Une clé binaire de n bits admet 2ⁿ valeurs. En moyenne, la bonne apparaît vers la moitié de l’espace, soit 2^(n−1) essais. À raison de r essais par seconde :
Prenons n = 256, la taille d’une clé AES-256, et r = 10¹⁵ : un million de machines hypothétiques essayant chacune un milliard de clés par seconde. Même à cette cadence immense, t vaut environ 2×10⁵⁴ ans.
L’Univers a environ 1,4×10¹⁰ ans, soit un écart d’environ 10⁴⁴ fois. Dans un modèle idéal, l’algorithme quantique de Grover réduit la complexité à sa racine carrée, approximativement une recherche sur 128 bits. Avec la même hypothèse de cadence simplifiée, cela représente encore plus de 10¹⁵ ans. Cette illustration n’est pas une prévision des performances d’un ordinateur quantique réel.
Ces coûts rendent la recherche exhaustive de la clé impraticable. Les algorithmes établis subissent des années d’analyse cryptographique ; les casser efficacement constituerait un résultat majeur. Nous avons donc étudié l’implémentation de l’appareil.
La question devient : quels codes, justificatifs et matériaux permettent le déchiffrement, et un contrôleur compromis peut-il réutiliser cette procédure ?
Deuxième voie : réutiliser le déchiffrement de l’appareil
Si l’appareil doit déchiffrer pour signer, son firmware contient nécessairement une voie permettant d’obtenir la clé. Le code qui reconstruit la clé devient la véritable cible.
En suivant ce code avec l’aide de l’IA, nous avons trouvé la relation suivante :
Après vérification des justificatifs, la puce A réalise deux étapes de KDF en interne puis trois opérations SHA-256, produisant une part A de 32 octets. La puce B applique un XOR entre une page de stockage protégée et une empreinte dérivée du code secret, produisant une part B de 32 octets. Les deux parts forment 64 octets, soumis à un hachage salé puis à SHA-512 ; les 32 premiers octets servent de matériau de clé. Celui-ci est enfin combiné à la clé AES de 32 octets inscrite dans l’OTP pour obtenir la clé de déchiffrement. Le troisième élément sécurisé sert surtout à l’authentification, notamment biométrique, et n’a pas le même rôle dans cette dérivation.
Imaginez un coffre à trois serrures : les trois clés sont nécessaires pour l’ouvrir. Elles correspondent aux matériaux de la puce A, de la puce B et de l’OTP.
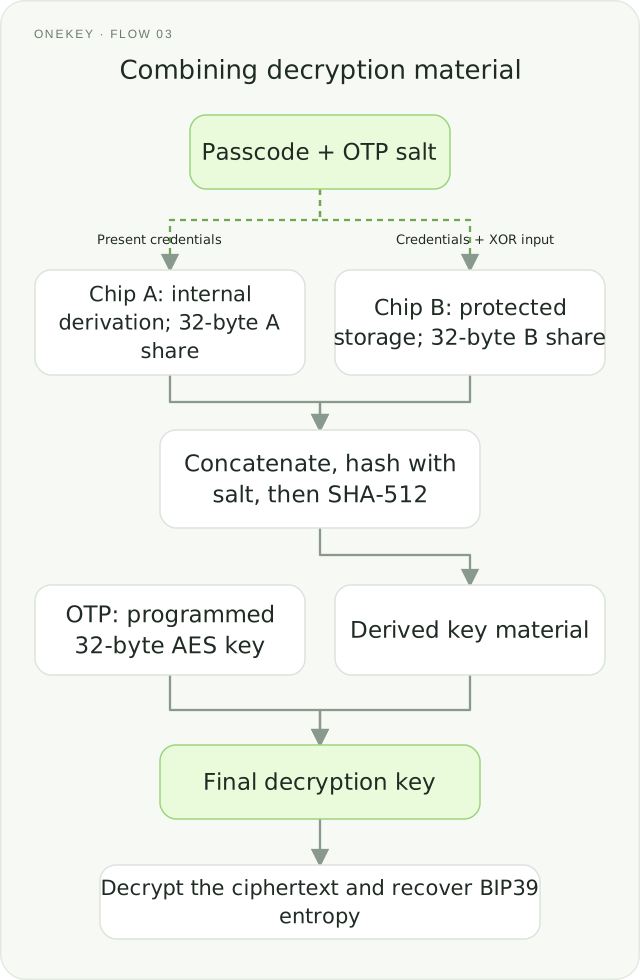
Le « code secret » désigne ici le PIN de l’appareil. Le sel et la clé AES sont deux valeurs aléatoires propres à chaque appareil, inscrites en usine dans la mémoire programmable une seule fois (OTP). Elles ne sont plus modifiables, mais peuvent rester lisibles. La fonction f du contrôleur utilise finalement ces données. Si ce contrôleur est compromis et que les matériaux requis sont accessibles, l’attaquant peut tenter la même récupération.
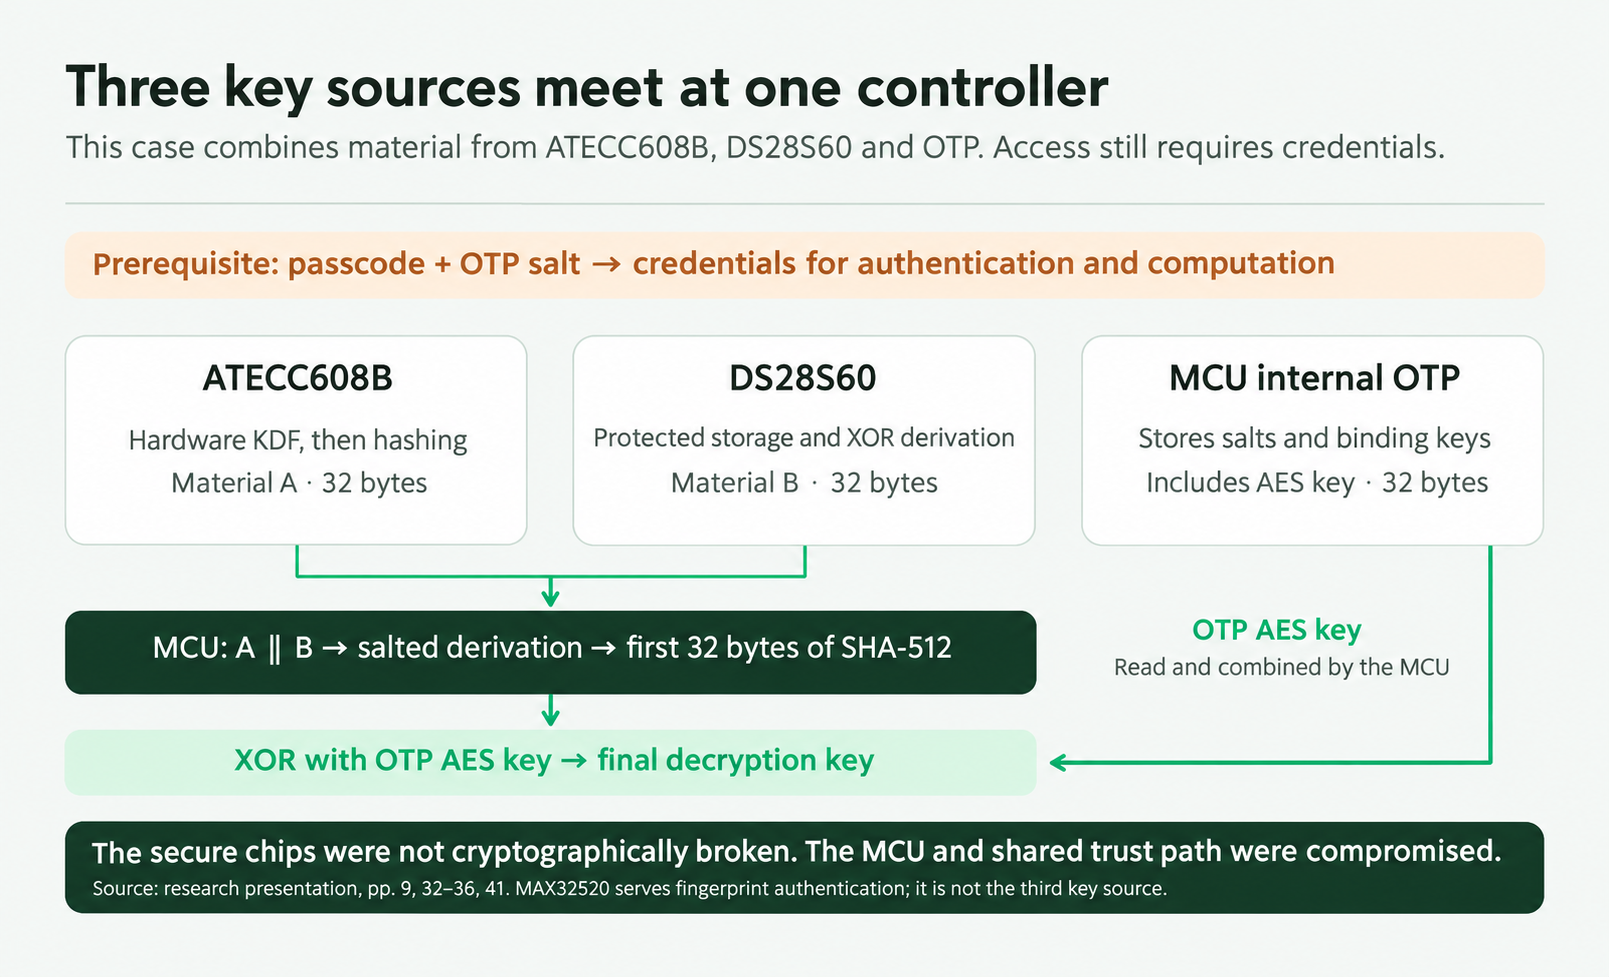
Comment obtenir ces matériaux ?
Commençons par le sel et la clé AES dans l’OTP. Le MPU contrôle les permissions de lecture, et le contrôleur principal peut reconfigurer ce MPU. Son contrôle peut donc permettre de modifier les permissions et de lire ces valeurs.
Le PIN constitue un autre paramètre nécessaire, en plus des données OTP.
4. Que deviennent les limites d’essais du PIN ?
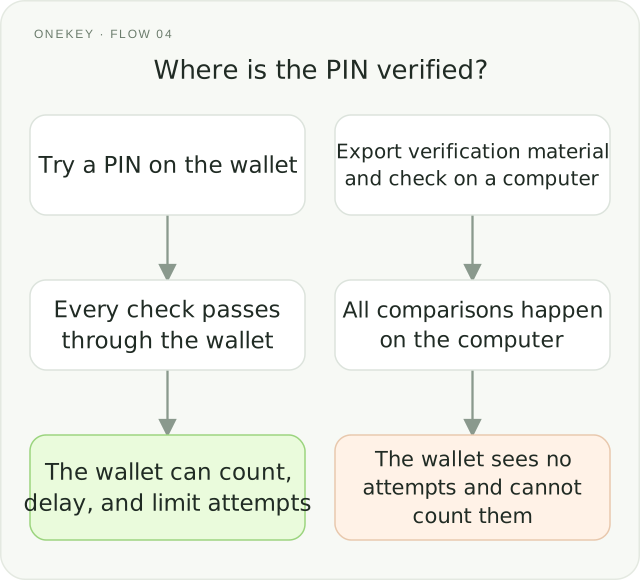
Cette section explique pourquoi, lorsque le matériau de vérification est lisible dans les conditions de l’expérience, une vérification hors ligne ne dépend plus du compteur d’échecs. Elle ne supprime pas les conditions initiales de déverrouillage et d’autorisation USB : l’avis officiel exige la connaissance du bon PIN.
Même si l’entrée exige une autorisation, il faut examiner si un MCU compromis peut exporter le vérificateur et si la limitation des essais reste alors effective.
Le PIN comporte six chiffres, et l’appareil est configuré pour effacer ses données après cinq erreurs. Comment évaluer cette protection ?
Nous avons demandé à l’IA de localiser la procédure de vérification et d’expliquer comment l’appareil décide qu’un code est correct.
Un appareil stocke généralement un vérificateur, plutôt que le PIN en clair : v = F(p, s). Ici, p est le PIN, s le matériau propre à l’appareil et F le calcul défini par le firmware. Dans ce cas, le calcul s’exécute sur le contrôleur. Même si p est inconnu, v, F et s peuvent être lus dans les conditions expérimentales.
La vérification peut alors être reproduite hors de l’appareil. Un calcul qui ne passe jamais par le portefeuille n’incrémente pas son compteur. Les essais de PIN peuvent être effectués entièrement sur un ordinateur.
La conception suppose que le contrôleur reste digne de confiance. La puce B applique des conditions différentes selon les données : le vérificateur est lisible avant la vérification, alors que le matériau de la part B utilisé pour déchiffrer est mieux protégé. Normalement, le contrôleur compte les échecs et déclenche l’effacement au cinquième.
Quand la vérification devient possible hors ligne, les 10⁶ combinaisons d’un PIN à six chiffres forment un espace fini échappant au compteur. Une expérience a trouvé le PIN après 1,831 seconde. La section complémentaire précise ce que ce temps permet, ou non, de déduire du coût d’une vérification.
Avec le PIN, le dernier paramètre est disponible. En suivant les algorithmes du firmware, on peut produire les justificatifs nécessaires aux étapes suivantes.
Lorsque tous les matériaux nécessaires sont réunis, la phrase peut être reconstruite, avec un risque de prise de contrôle des comptes correspondants.
5. Quel risque du point de vue de l’utilisateur ?
Nous avons suivi l’analyse technique. Plaçons-nous maintenant du côté du propriétaire du portefeuille.
Scénario 1 : ancien firmware et connexion USB autorisée
Il faut d’abord savoir si l’appareil utilise un ancien firmware affecté et si toutes les conditions de l’avis sont réunies. La présence d’un malware sur l’ordinateur ne prouve pas, à elle seule, qu’un portefeuille verrouillé peut être compromis.
Cette voie USB nécessite un appareil déverrouillé, une connexion approuvée et un ordinateur contrôlé par l’attaquant. Brancher un câble de recharge ne remplit pas ces conditions.
Ce n’est qu’ensuite que l’hôte malveillant peut atteindre la logique vulnérable de traitement des requêtes USB.
L’étude démontre cette voie conditionnelle : envoyer une requête construite, affecter le MCU, puis suivre les procédures existantes pour obtenir les matériaux requis.
Si tous les matériaux de récupération peuvent être réunis, les actifs correspondants peuvent être menacés. Ce résultat ne s’étend pas à tous les firmwares, tous les usages ni tous les portefeuilles matériels.
Scénario 2 : possession physique de l’appareil
L’accès physique ouvre d’autres pistes de recherche. Les principes qui suivent ne signifient pas que ces techniques ont été démontrées dans ce cas, ni que posséder l’appareil suffit à contourner le PIN.
L’ouverture du boîtier, les sondes et l’injection de fautes permettent d’examiner les protections du MCU. Le processeur dépend de son alimentation et de son horloge. Sur certains appareils et dans certaines conditions, une perturbation brève peut affecter une vérification. Le résultat dépend de la puce, de sa configuration et de ses défenses.
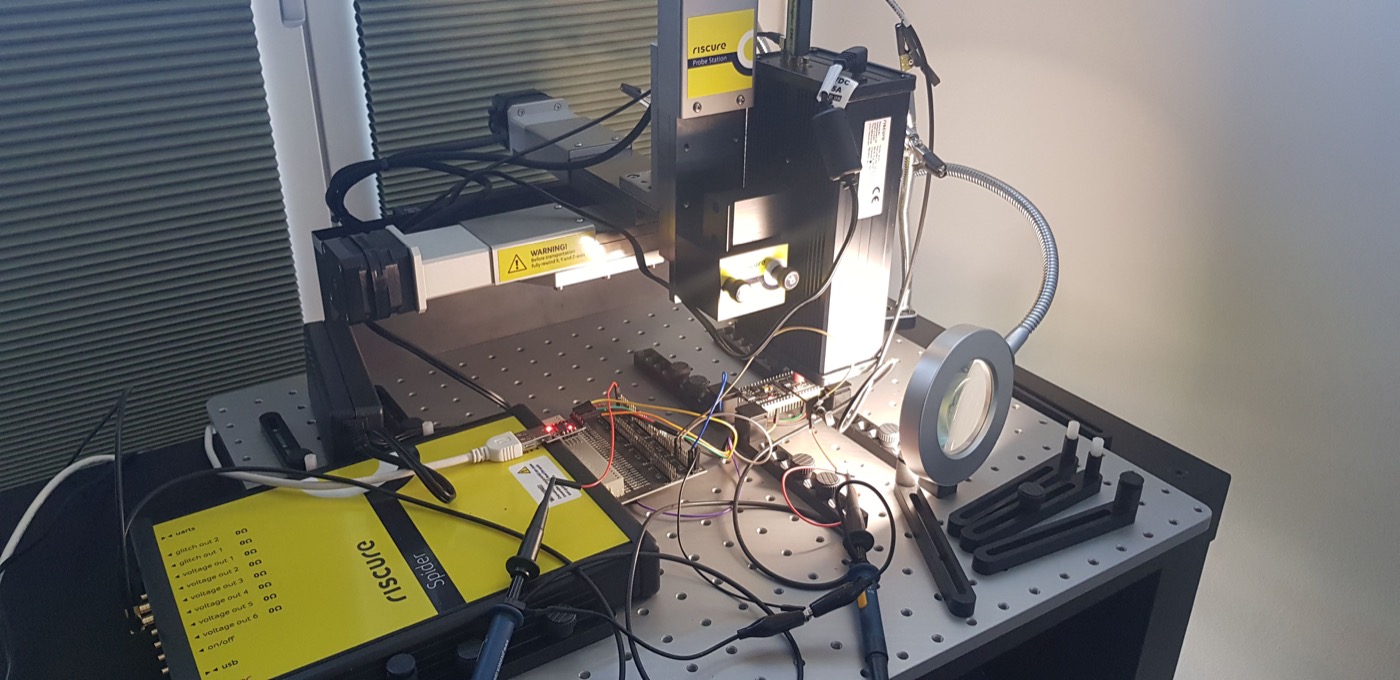
Même après le contrôle du MCU, l’accès aux autres matériaux dépend encore des justificatifs, des autorisations des puces et des protections indépendantes.
Ce cas rappelle qu’une sécurité dédiée doit être évaluée à l’échelle du système complet. En reliant plusieurs défauts d’implémentation avec l’aide de l’IA, un attaquant peut progressivement franchir les frontières prévues par la conception.
4. Quel a été le rôle de l’IA ?
En reliant les étapes, on obtient la chaîne suivante :
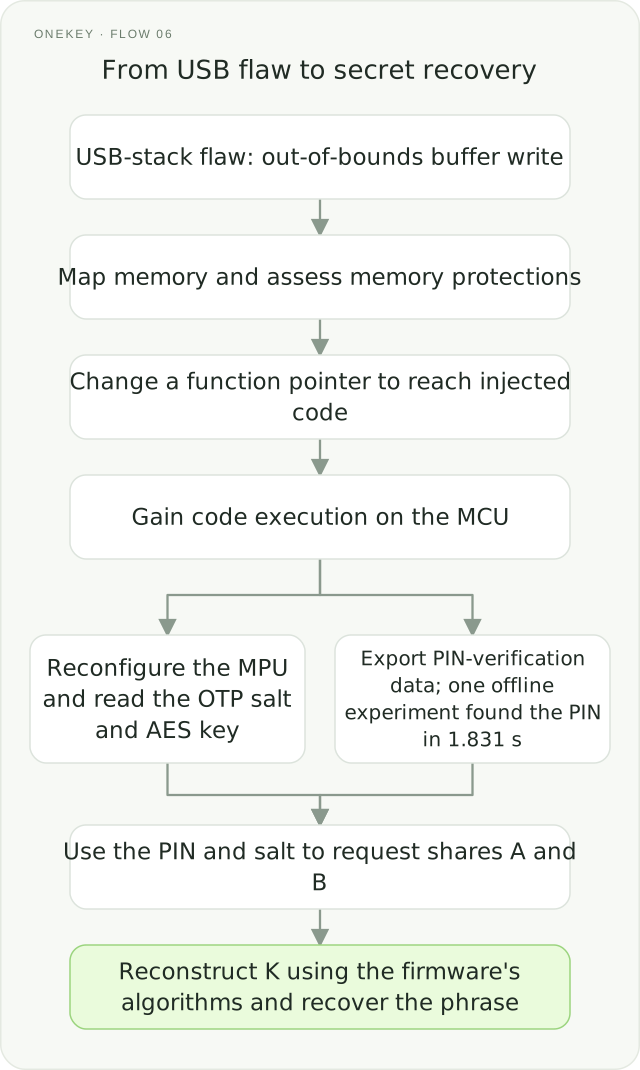
L’IA a surtout aidé à analyser la faille, modifier les outils, localiser le code et faire correspondre les données. Les chercheurs ont défini la démarche ; l’IA a assumé une grande part du travail minutieux qui exige de l’expérience, permettant de poursuivre l’analyse et les vérifications.
Pour un débutant en systèmes embarqués, la compréhension du code et le débogage constituent souvent les principaux obstacles. L’IA peut expliquer, organiser les indices et aider à vérifier les hypothèses, permettant d’avancer là où la recherche s’arrêtait auparavant.
La création de sites web offre un exemple familier. Elle demandait beaucoup de temps à une personne sans expérience de programmation ; des demandes en langage naturel peuvent désormais produire des pages utilisables. Les escrocs peuvent employer les mêmes capacités pour imiter des banques, rendant les pages de phishing plus faciles à créer et plus difficiles à reconnaître.
L’IA intervient aussi dans d’autres étapes du travail.
Les outils d’IA dans le cloud comportent généralement des restrictions de sécurité. Des outils moins limités peuvent servir à davantage de tâches offensives. Reliée à des alimentations de laboratoire, des sondes et des appareils d’injection de fautes, l’IA peut aussi aider à écrire les logiciels de commande et à organiser les mesures.
Raelize a publié un exemple concret en mai 2026. Les chercheurs ont assemblé le matériel, fourni le câblage et la documentation, puis utilisé Claude Code pour écrire les programmes pilotant l’injection de fautes et l’alimentation. L’expérience aidait à reproduire un contournement connu du démarrage sécurisé sur un ancien ESP32. Compte rendu Raelize
Le démarrage sécurisé vérifie l’authenticité du firmware avant son exécution. Le code suppose que le processeur exécute correctement les instructions, mais la puce dépend de conditions physiques, dont la tension et l’horloge. L’injection de fautes les perturbe brièvement, par exemple par une impulsion de tension, pour provoquer une erreur susceptible de contourner un contrôle.
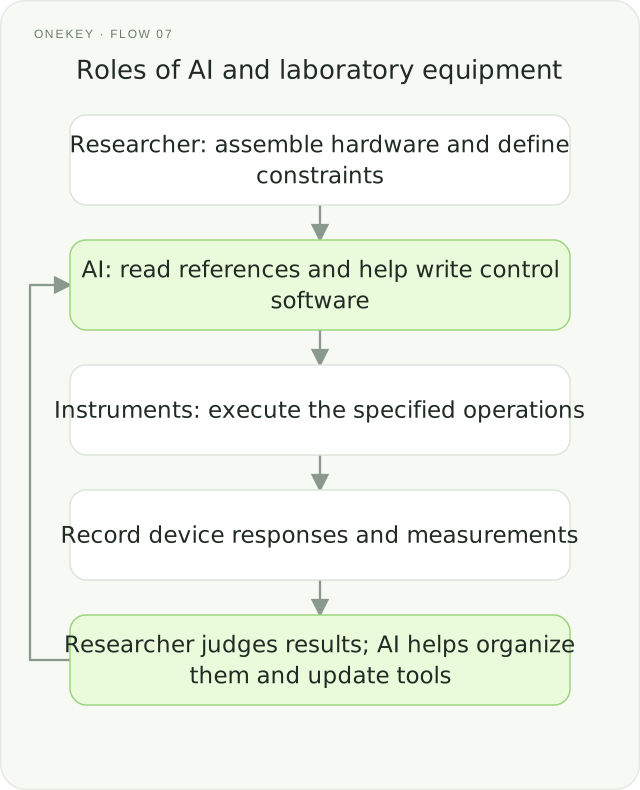
Du code aux expériences, l’IA relie des informations dispersées et réduit l’effort nécessaire pour les traiter. Cette capacité sert aussi bien à l’analyse offensive qu’à la défense.
La sécurité matérielle et logicielle reste donc centrale à l’ère de l’IA. Les travaux de NVIDIA sur l’isolation matérielle et les limites de permissions dans l’infrastructure IA partagent un principe général avec l’isolation des opérations sensibles d’un portefeuille. NVIDIA Sentry, architecture de sécurité des agents, annonce DSX POD. La baisse du coût de l’analyse et de l’automatisation exige un investissement continu dans les défenses.
5. La sécurité de la chaîne d’approvisionnement compte aussi
Le code USB vulnérable provenait du SDK du fabricant de puces. Une revue de sécurité doit donc couvrir la logique du portefeuille, les pilotes, les piles de communication, ainsi que leur configuration et leurs interactions dans l’appareil complet.
Les jetons bancaires, jetons de sécurité et terminaux de paiement répartissent les responsabilités de façon comparable : le logiciel traite les demandes externes et les transmet aux composants qui protègent les secrets et exécutent les opérations. Les objets protégés diffèrent, mais les mécanismes ont des points communs. Normes PCI pour terminaux de paiement
Les composants de bas niveau sont souvent communs à plusieurs produits. Un fournisseur distribue un SDK que plusieurs fabricants intègrent. Une faille dans ce code partagé peut donc étendre son impact le long de la chaîne d’approvisionnement.
Un fabricant ne peut pas examiner uniquement son propre code applicatif. L’utilisateur achète un appareil complet, quel que soit l’auteur du composant vulnérable. Un pilote peut compromettre une logique de portefeuille pourtant correcte. Le fabricant reste responsable de l’évaluation de la sécurité du système complet.
La correction exige aussi une coordination : le fournisseur corrige le SDK, les fabricants identifient les produits concernés, adaptent et testent le firmware, puis les utilisateurs installent les mises à jour. Ce cas a été corrigé dans v2.4.0 ; les utilisateurs d’anciennes versions affectées doivent passer par les canaux officiels pour mettre à jour. Relier chaque risque à ses versions évite de confondre une recherche historique avec l’état actuel du produit.
La sécurité doit couvrir tout le cycle de vie : conception matérielle et logicielle, authenticité des emballages, communication, exploitation et réparation. Chaque étape nécessite une vigilance et des vérifications adaptées.
L’équipe OneKey Anzen intègre aussi ces enseignements à ses propres conceptions. L’IA peut organiser des indices pour les attaquants et nous aider, nous aussi, à examiner le code et les hypothèses.
Annexe illustrée : de données aléatoires à 24 mots de récupération
La phrase de récupération permet de restaurer un portefeuille. Voyons comment une suite de bits aléatoires devient vingt-quatre mots.
Dans le format BIP39 à 24 mots, les données initiales ont 256 bits, chacun valant 0 ou 1, soit 2²⁵⁶ combinaisons. On calcule une somme de contrôle de 8 bits et on l’ajoute pour obtenir 264 bits.
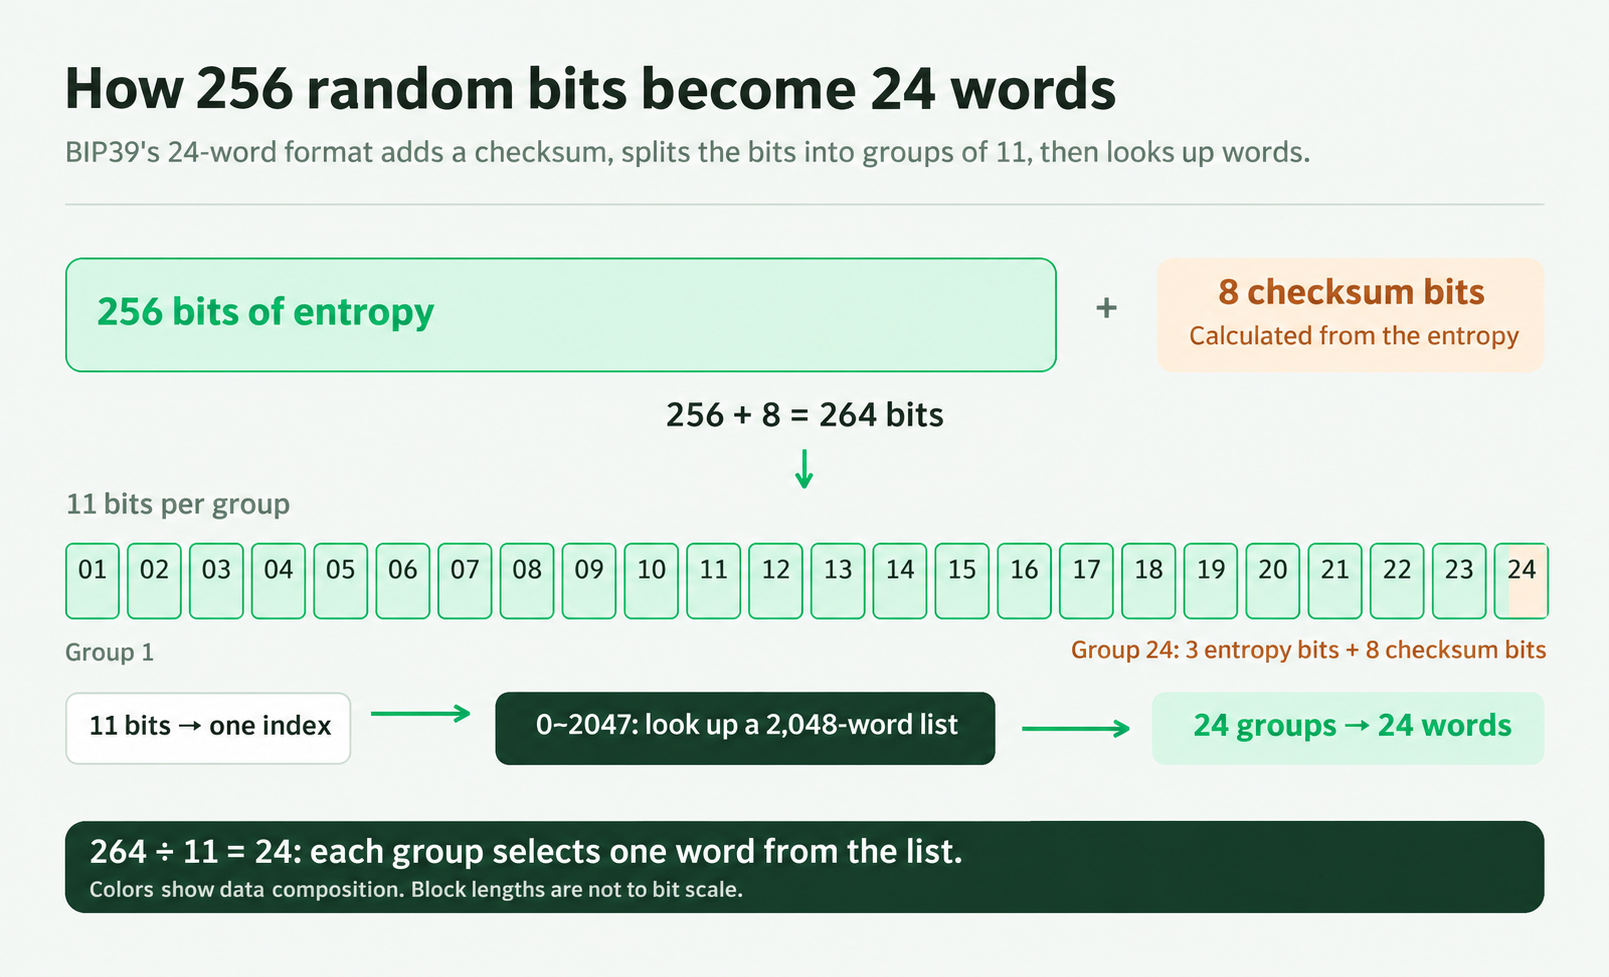
Ces bits sont répartis en groupes de 11. Chaque groupe représente l’un des 2¹¹ = 2048 indices correspondant à une liste de 2048 mots. Comme 264 ÷ 11 = 24, le résultat contient vingt-quatre mots.
256 + 8 = 264 = 24 × 11.
Les 8 derniers bits sont calculés à partir des données d’origine. Ils n’ajoutent aucun hasard et ne rendent pas la recherche plus difficile. Ils détectent certaines erreurs de transcription ; ce n’est pas du chiffrement. La liste associe simplement un indice à un mot et peut être publique.
La phrase et une passphrase indépendante facultative génèrent une graine, dont les clés sont dérivées selon des règles comme BIP32. La même phrase et la même passphrase, avec les mêmes règles de dérivation, restaurent le même compte. Spécification BIP39, spécification BIP32
Pour aller plus loin
1. Partage de secret et autorisation indépendante
Diviser un secret ne confère pas automatiquement un contrôle d’accès indépendant à chaque part. Si une même entité compromise peut toujours demander toutes les parts, leur séparation ne crée pas, à elle seule, de difficulté de calcul supplémentaire pour cette entité.
Considérons un partage XOR à deux parts. Soit le secret et un masque choisi uniformément dans , indépendamment de . Définissons :
Ici, désigne le XOR bit à bit.
Une part seule ne révèle rien sur . Pour toute valeur fixée du secret et de la part ,
Le membre droit ne dépend pas de : la distribution conditionnelle de est indépendante de . Observer ne change donc aucune croyance sur . De même, et est indépendant de , donc ne révèle rien sur . Cela suppose un masque uniforme, indépendant et non réutilisé entre secrets.
Les deux parts permettent en revanche la reconstruction, puisque le XOR s’annule :
Le schéma est donc correct : une part seule ne fournit aucune information, tandis que les deux réunies restituent le secret de façon certaine.
Deux hypothèses de sécurité doivent être distinguées. Le partage répond à la perte d’une part, pas automatiquement au détournement du chemin de requête. Si le contrôleur compromis reste autorisé et que les puces lui renvoient leurs parts, l’attaquant collecte les matériaux par le protocole normal sans analyser cryptographiquement le texte chiffré. Chaque part doit donc disposer d’autorisations indépendantes du MCU ; compromettre celui-ci ne doit pas ouvrir automatiquement les autres composants.
2. Durée d’une recherche de PIN hors ligne et rôle du sel
Un PIN décimal à six chiffres possède candidats. Si chaque vérification passe par l’appareil, compteurs, délais et effacement peuvent empêcher une recherche exhaustive pratique. Après exportation du vérificateur et reproduction du calcul sur un hôte, l’appareil ne contrôle plus les essais. Dans ce modèle simplifié, le coût dépend du nombre de candidats et du temps par essai .
Supposons un PIN uniforme et une recherche sans répétition. Chaque position de est équiprobable ; le nombre moyen d’essais vaut donc
La durée moyenne correspondante est .
On ne peut pas simplement diviser les secondes observées par . La recherche s’arrête au bon PIN : ce temps porte sur les premiers candidats, pas nécessairement sur tout l’espace. Si la position du bon PIN est , le temps par essai est
Ce n’est que pour que l’on obtient seconde. Pour tout , est strictement supérieur. Ainsi, constitue une borne inférieure par essai. La durée d’exploration complète, , est également d’au moins secondes.
Par exemple, une recherche séquentielle commençant à avec le PIN donne et . Examiner les candidats demande environ secondes, pour une durée moyenne d’environ secondes. Les chiffres dépendent de , mais le constat reste le même : dans ces conditions, une vérification hors ligne sans compteur rend l’espace de candidats abordable sur un ordinateur ordinaire.
Le sel fait produire à un même code des vérificateurs différents selon les appareils, empêchant de réutiliser une table précalculée. Il modifie le coût amorti entre plusieurs cibles, sans agrandir l’espace d’un appareil donné. Une fois les matériaux disponibles, cet espace reste et le coût par essai .
Conclusion
L’IA prend en charge une grande part de l’analyse et des essais les plus fatigants et les plus exigeants en expérience. Suivre le code, comparer la mémoire, localiser les défauts et modifier les outils progresse désormais par itérations plus rapides. Les chercheurs jugent la direction et valident les résultats ; l’IA réduit le temps et l’effort nécessaires pour concrétiser une idée. C’est là que les barrières à l’attaque diminuent.
Les mêmes capacités renforcent la défense : revue de code, validation des failles et examen de la chaîne d’approvisionnement. Comprendre ce travail permet de mieux évaluer les risques et de cibler les protections utiles.
FAQ
Elle aide à lire le firmware, suivre les paramètres, relier les structures à la mémoire, organiser les expériences et modifier les outils. Les chercheurs définissent les objectifs et les méthodes, puis vérifient la fiabilité des résultats.
Le chemin étudié exploite des défauts d’implémentation et d’autorisation pour obtenir les matériaux de déchiffrement. Il ne casse pas AES. L’IA aide surtout à analyser le code et les données ; cette recherche ne démontre pas une rupture du chiffrement moderne.
Le nombre de puces ne suffit pas. Le partage des secrets doit s’accompagner d’autorisations indépendantes. Si toutes font confiance au même MCU compromis, celui-ci peut encore recueillir les matériaux par les procédures existantes.
L’appareil ne compte que les vérifications qui passent par lui. Si le vérificateur peut être exporté et le calcul reproduit ailleurs, les essais ne lui parviennent plus. Le risque dépend des permissions d’export, de la méthode de vérification et de l’autorisation.
Les portefeuilles dépendent souvent de pilotes et de piles fournis par les fabricants de puces. Une faille partagée peut toucher plusieurs produits. Il faut examiner l’intégration complète et coordonner corrections, adaptation du firmware, tests et mises à jour.






