ИИ ставит хакеров на поток — порог входа в атаки снижается
Ключевые выводы
- ИИ упрощает анализ уязвимостей и проверку атак.
- Защита кошелька зависит от чипов, PIN и архитектуры системы.
- Ошибки сторонних компонентов создают риски в цепочке поставок.
1. Когда хакеры начинают писать код с ИИ
ИИ уже стал частью повседневной работы. Нужен небольшой инструмент — достаточно описать задачу, попросить первую версию, запустить её и внести исправления. После нескольких итераций нередко получается рабочая программа.
ИИ берёт на себя многие из самых трудоёмких задач анализа безопасности, требующих большого опыта. Прослеживание цепочек вызовов, сопоставление памяти с кодом, поиск сбоев и постоянная доработка тестовых инструментов раньше требовали множества ручных итераций. Теперь ИИ помогает продвигаться на каждом этапе. Человек по-прежнему выбирает направление и проверяет результат, а ИИ выполняет значительную часть анализа и экспериментов, превращающих идею в проверяемый подход.
Те же возможности пригодны для атак. Один человек просит ИИ разобраться в проекте и реализовать функцию, другой — проследить вызовы, изучить память и изменить инструменты, чтобы найти путь в сеть или устройство. Работа похожа; цель зависит от того, кто ставит задачу.
Так ИИ на практике снижает порог входа в атаки. Раньше многие останавливались на повторяющихся задачах, для которых одновременно требовались специальные знания. Теперь базовые навыки программирования и работы с аппаратурой вместе с помощью ИИ позволяют продвинуться дальше. Даже мошенники без опыта разработки могут создавать убедительные фишинговые сайты.
На примере исследования команды OneKey Anzen рассмотрим вклад ИИ в анализ аппаратных атак: оценку кошелька с тремя защищёнными чипами и того, насколько далеко может продвинуться атакующий с помощью ИИ.
Этот пример начинается с уязвимости USB — ошибки реализации, которая может встречаться и в других устройствах. Аппаратные кошельки специально проектируют для защиты цифровых активов. Пошаговый разбор помогает отрасли оценивать границы доверия, а читателям — понимать реальные возможности атак с участием ИИ.
Область исследования и исправление: статья посвящена совместному аудиту OneKey Anzen и Keystone. Проблема затрагивала USB SDK в старых версиях прошивки Keystone 3 Pro и была исправлена в v2.4.0 от 1 апреля 2026 года. В официальном сообщении перечислены обязательные условия: физический доступ к устройству, знание правильного PIN-кода, разблокированное устройство, разрешение USB-подключения и подключение к компьютеру под контролем атакующего. На момент публикации сообщения обе стороны не обнаружили свидетельств эксплуатации против пользователей. Разбор ниже не означает, что актуальная прошивка остаётся уязвимой или что для атаки достаточно зарядки. Официальное исследование и обновление безопасности
2. Что такое аппаратный кошелёк?
Чтобы понять аппаратный кошелёк, начнём с основ блокчейна.
Представьте реестр, который совместно ведут тысячи компьютеров — распределённая сеть серверов. В нём учитываются криптовалюты, например биткоин. Как и у зарегистрированного имущества, право собственности отражается в записях, а не в наличных деньгах на руках.
Чем подтвердить, что актив принадлежит вам? Фраза восстановления открывает доступ к ключам, разрешающим распоряжаться им. Ключи можно сравнить с электронной печатью: тот, кто способен её поставить, может авторизовать транзакцию. В отличие от банковской карты, её нельзя просто объявить потерянной и перевыпустить. Получив необходимые данные восстановления, посторонний может получить контроль над соответствующими активами.
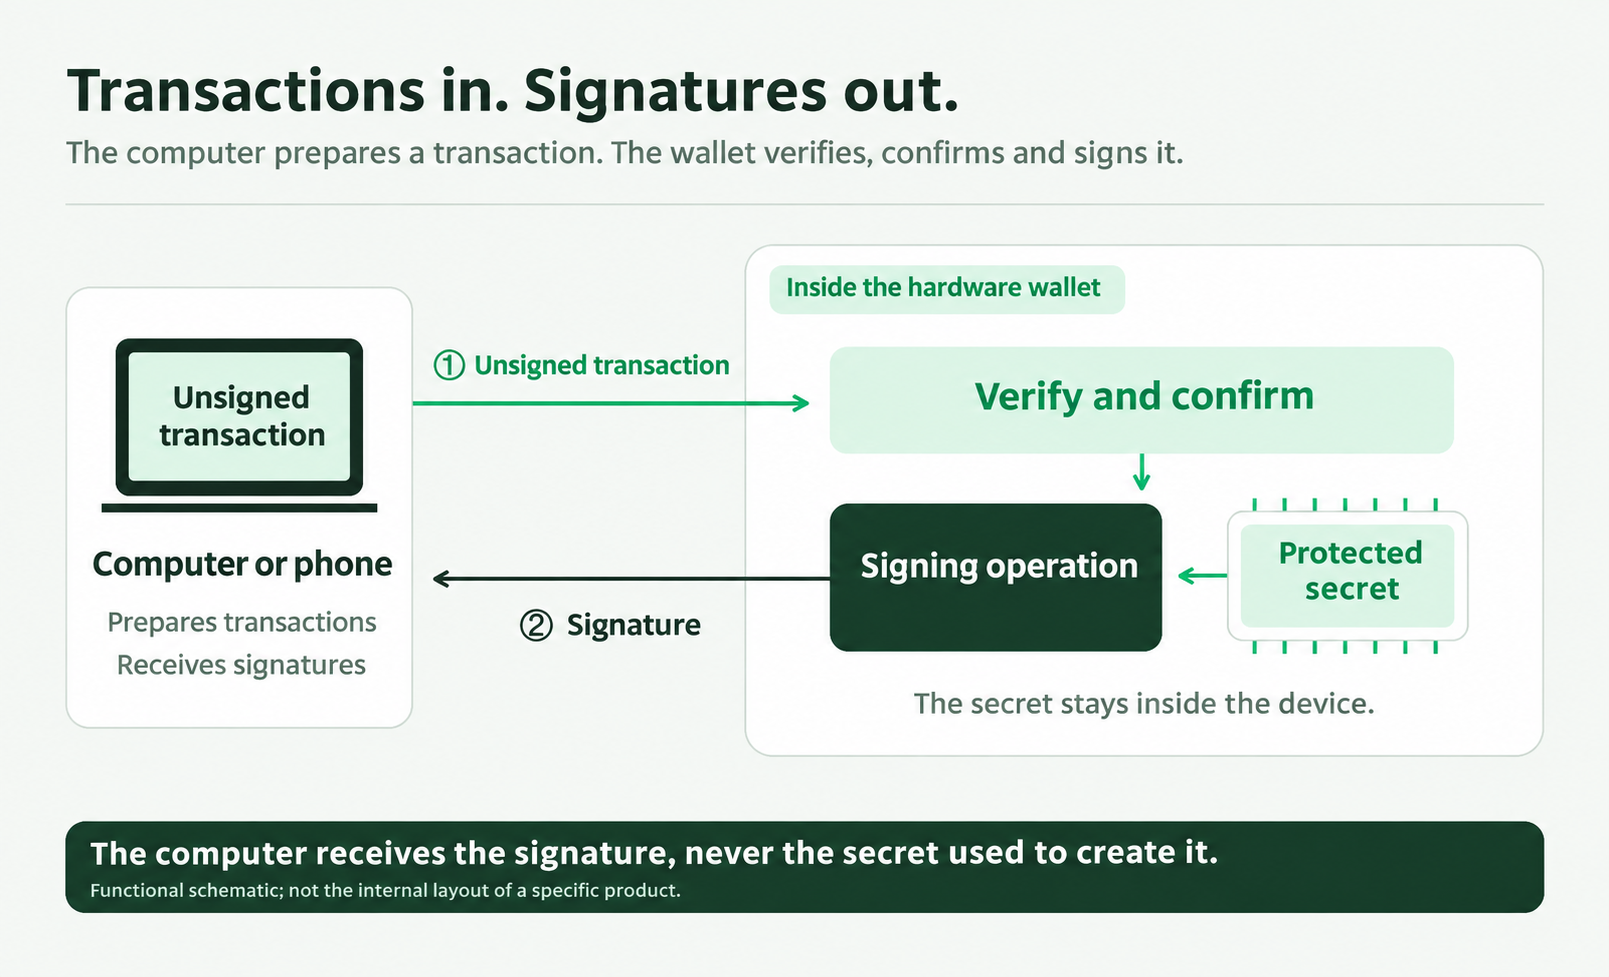
Аппаратный кошелёк защищает эту печать. Главный контроллер общается с компьютером и координирует компоненты; защищённые чипы (SE) хранят секреты и проверяют условия доступа. При переводе компьютер готовит транзакцию, а устройство подписывает её внутри себя. Компьютер получает подписанный документ, а не саму печать.
Этот принцип уже используется в банковских USB-токенах, платёжных картах и удостоверениях личности: отдельная аппаратура хранит секреты и выполняет чувствительные операции внутри себя. Аппаратные кошельки применяют ту же идею к цифровым активам. Банковские токены, платёжные и идентификационные чипы, чипы удостоверений личности
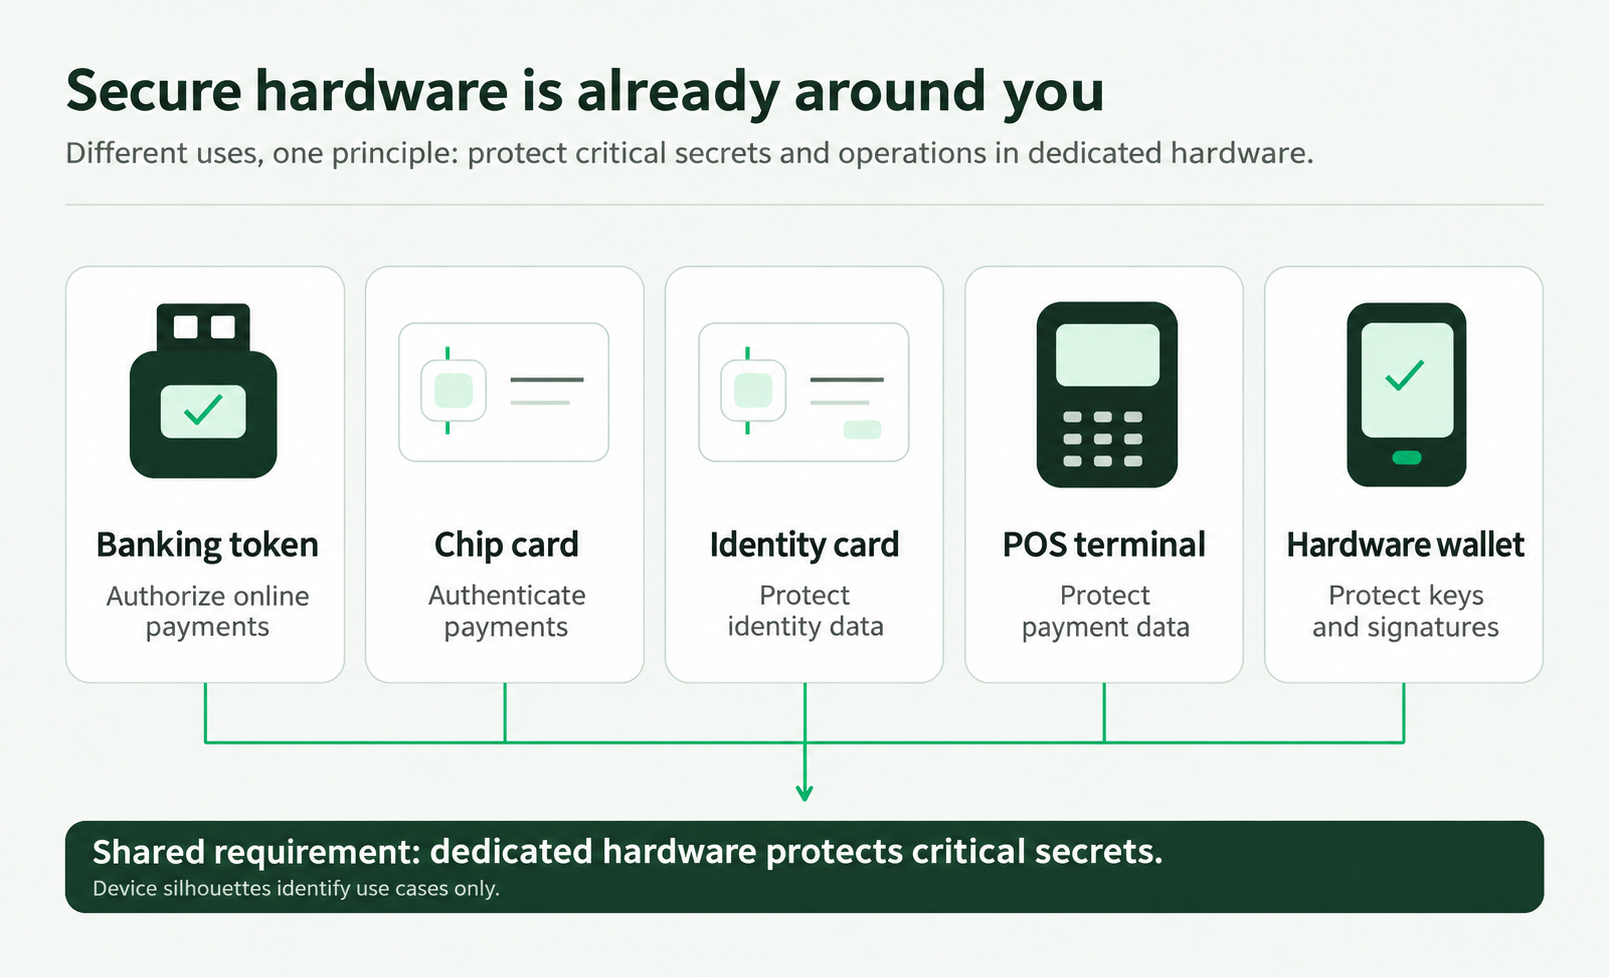
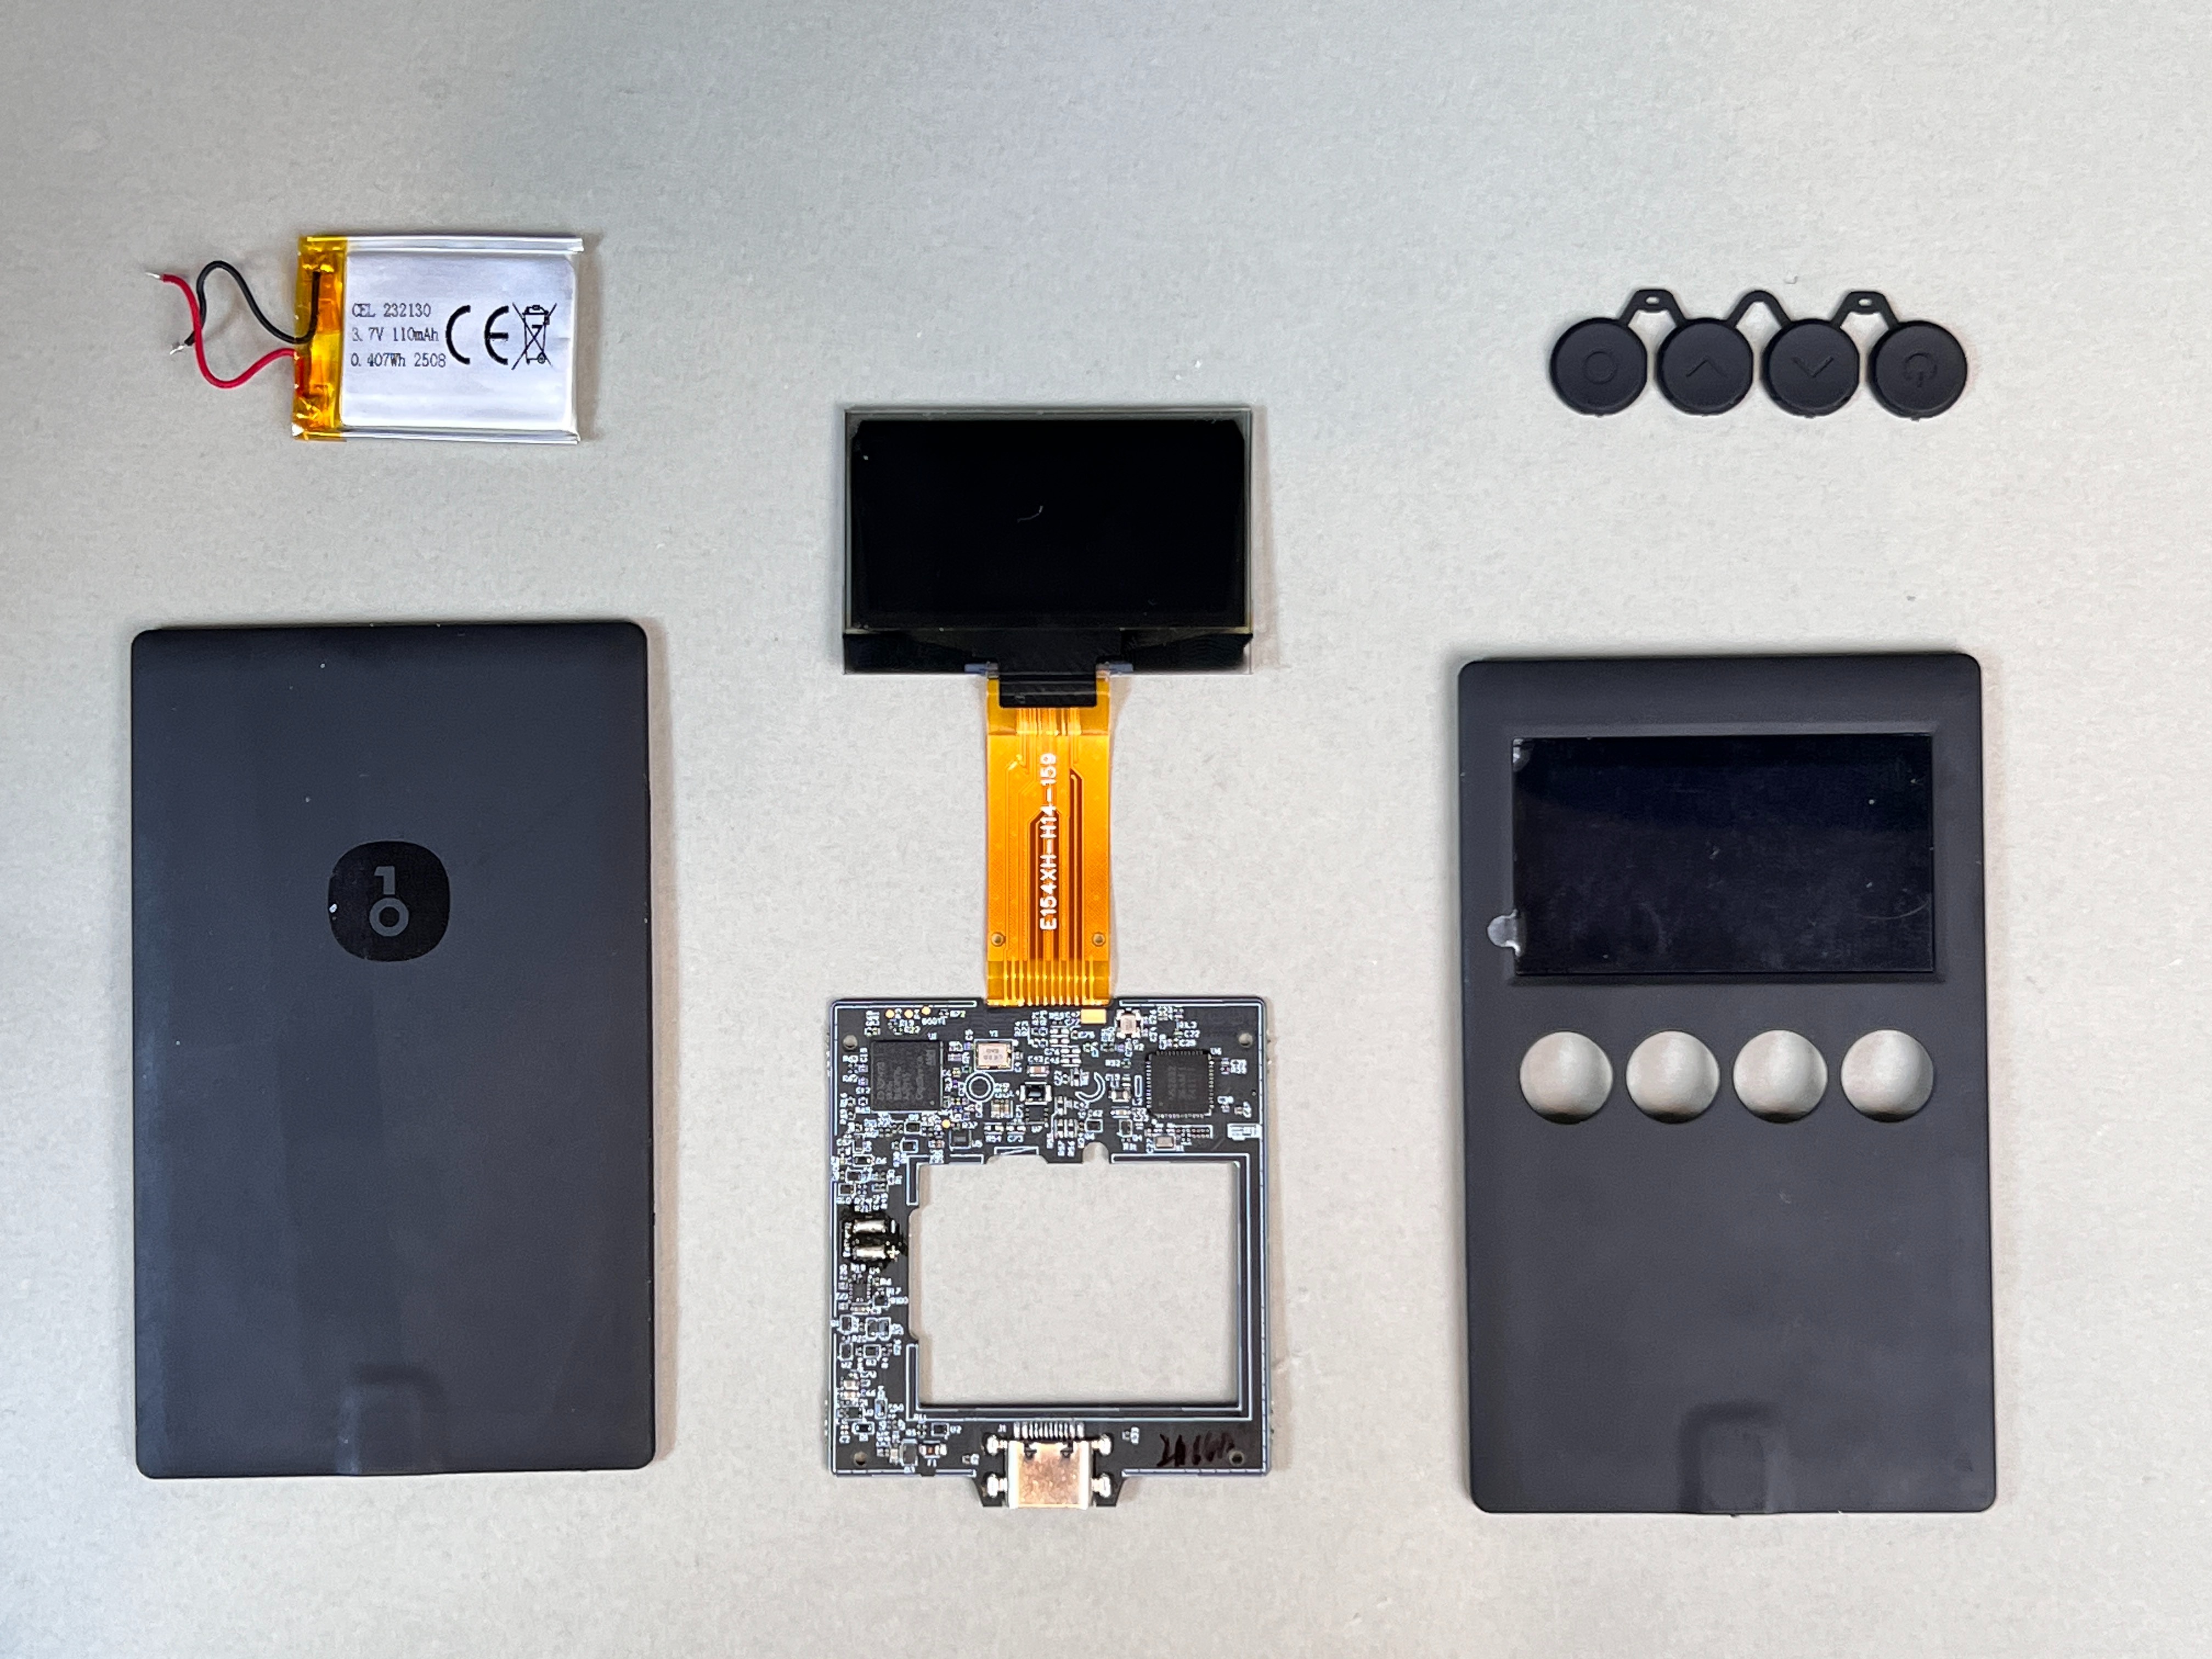
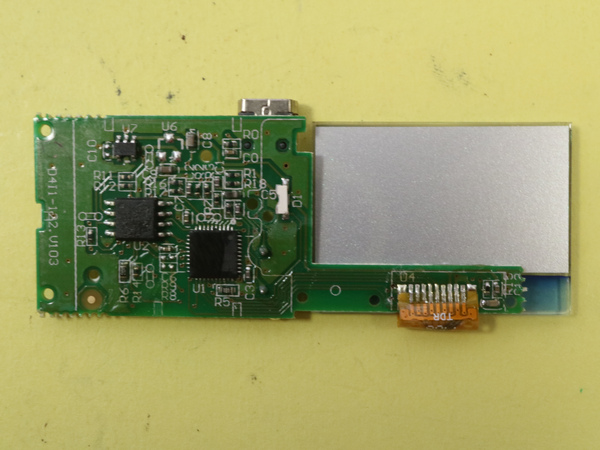
Примеры устройств | OneKey иллюстрирует конструкцию аппаратного кошелька. Фотографии: официальная разборка OneKey, разборка BugWorkShop, крупный план карты от kuhnmi (CC BY 2.0, изменён размер).
Поэтому аппаратные кошельки интересны для исследований: обнаруженные слабости могут встречаться и в других защитных устройствах. Их применение также выходит за рамки хранения электронной печати.
Когда ИИ начинает платить, подписывать запросы и действовать от имени человека, управление идентичностью и правами становится особенно важным. Один из подходов — собрать авторизацию в единой точке подтверждения, где человек решает, какие действия разрешены. Аппаратный кошелёк может стать такой точкой.
Теперь проследим анализ аппаратного кошелька и посмотрим, где помогает ИИ.
3. Как ИИ помогает анализировать аппаратный кошелёк
1. Начинаем с обычной ошибки
Этот случай возник в ходе совместного аудита с другим производителем кошельков. Мы хотели оценить устройство с помощью ИИ и выяснить, насколько далеко атакующий может пройти через обычный пользовательский интерфейс. Сначала требовалось выбрать точку входа.
Кошелёк позиционируется как изолированный холодный кошелёк: в нём нет Bluetooth и Wi-Fi, а транзакции передаются через камеру, SD-карту или USB.
У него три защищённых чипа. Данные, необходимые для восстановления кошелька, распределены между компонентами, а главный контроллер передаёт запросы и ответы. Эти сведения публичны; новичкам ИИ может помочь разобраться в документации и открытом исходном коде прошивки.
Мы ограничили поиск USB и SD-картой. Исследовались обычные интерфейсы без вскрытия корпуса, поэтому щупы, изменение проводки, инъекции сбоев, побочные каналы, отладочные порты JTAG/SWD и атаки на загрузчик оставались за рамками работы. С USB пользователь может столкнуться при подписании или зарядке.
Направление стало понятным: выяснить, позволяет ли USB повлиять на главный контроллер, выполнить на нём код атакующего и затем использовать штатные процедуры для запроса нужных данных. Реализации USB-стеков давно известны ошибками безопасности памяти, поэтому это была перспективная область поиска.
Этот путь касается затронутой старой прошивки и требует всех перечисленных выше условий. Устройство необходимо разблокировать и разрешить USB-соединение. Само подключение кабеля или зарядка канал атаки не открывают.
Стек USB реализует правила общения компьютера с устройством. Производитель чипа превращает стандарт USB в код и включает его в комплект разработки — SDK. Производитель устройства интегрирует этот код в продукт. Часть, принимающая и обрабатывающая USB-сообщения, и есть USB-стек.
Единый интерфейс не гарантирует одинаковое качество реализации и сопровождения. Некоторые фрагменты используются годами без нового анализа. Уязвимости часто скрываются именно в таких деталях: одного дефекта может хватить, чтобы поле сообщения, управляемое компьютером, вызвало ошибку.
В стеке много уровней: дескрипторы, управляющие запросы, команды классов и конечные точки передачи данных. Точек входа много, поэтому поиск нужно сузить.
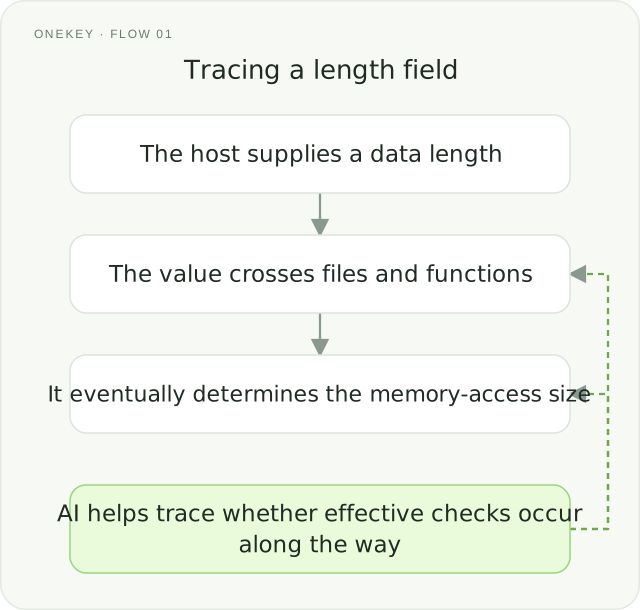
Мы сосредоточились на полях длины. Они могут поступать извне и определяют, сколько байтов устройство прочитает или запишет, куда поместит входные данные и к какому объёму памяти обратится.
Доверие к длине, присланной компьютером, может привести к выходу за границы. Допустим, буфер вмещает 8 байт, а запрос требует записать 1000. Если программа выполнит запись, лишние данные затронут соседнюю память и могут создать условия для внедрения кода. Важно проверить каждую длину по доступной ёмкости до фактического обращения.
Длины передаются между слоями настолько часто, что каждый слой может считать проверку обязанностью предыдущего. Одного такого предположения достаточно, чтобы значение прошло всю цепочку без корректной проверки границ.
В большинстве путей проверки работают. Трудность — найти исключение. Обычно исследователь идёт от точки входа через все функции и файлы, фиксируя источник значения, его преобразования, конечное использование и проверки по пути.
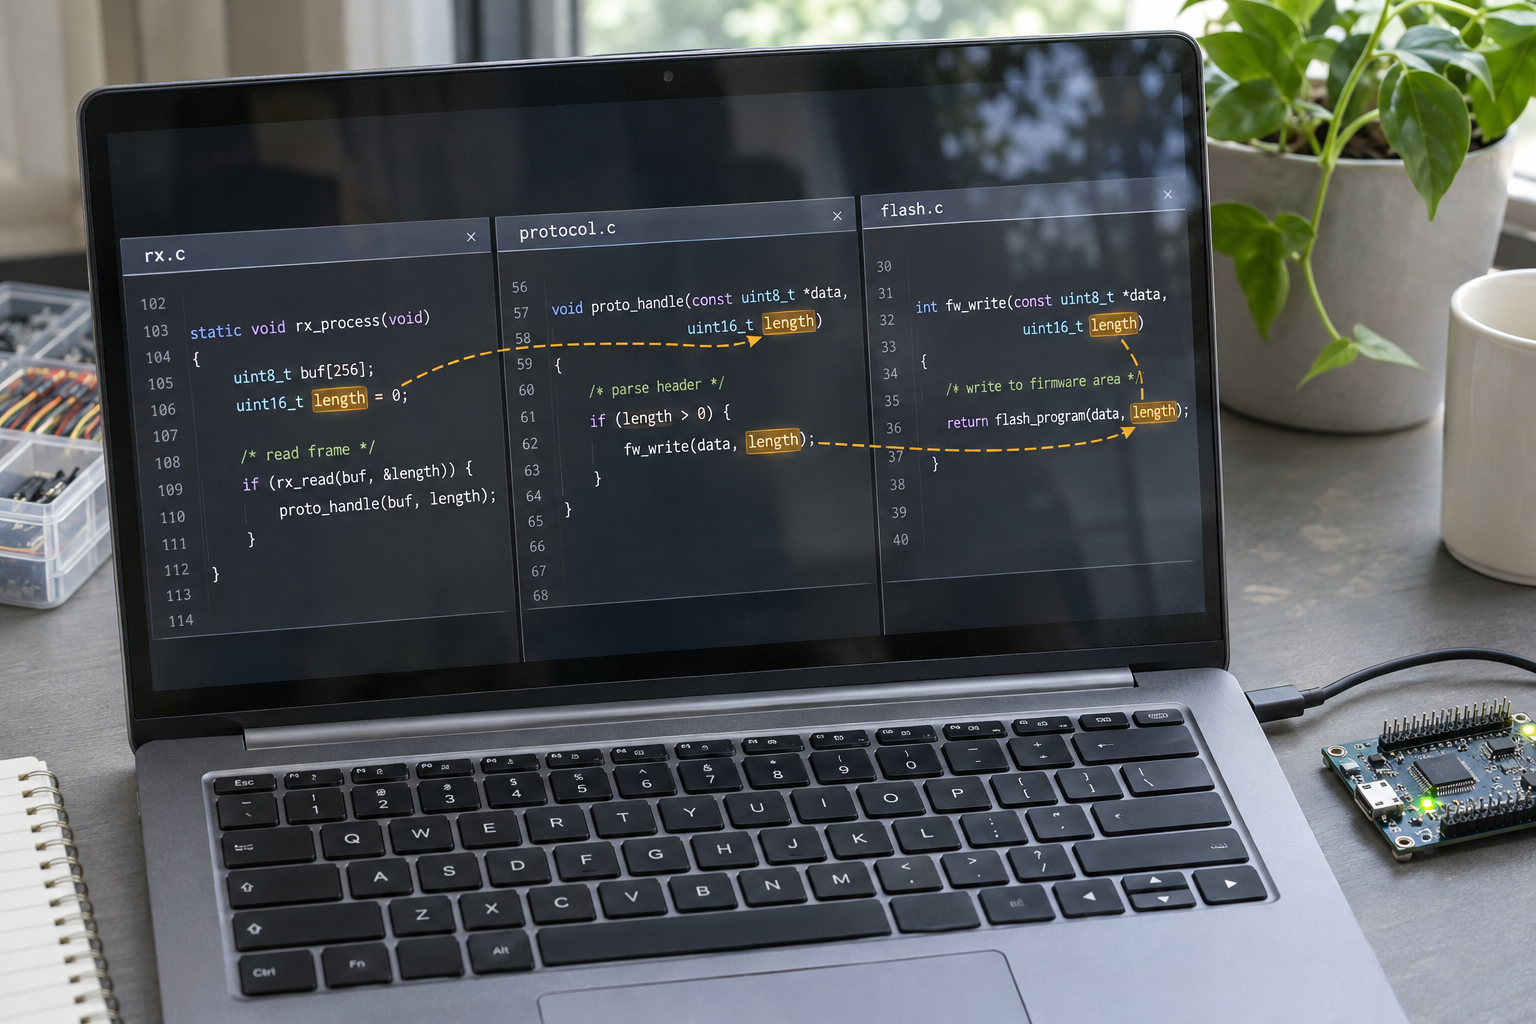
Отдельная функция может лишь принять длину и передать дальше. Вся цепочка намного длиннее: значение проходит десяток вызовов и несколько файлов, усекается, получает смещение, сохраняется в структуре и позднее извлекается.
К третьему файлу легко забыть происхождение исходного значения. Полей много, и каждое нужно разобрать полностью. Работа требует опыта и выносливости: опыт задаёт направление, а длительная концентрация сохраняет точность деталей.
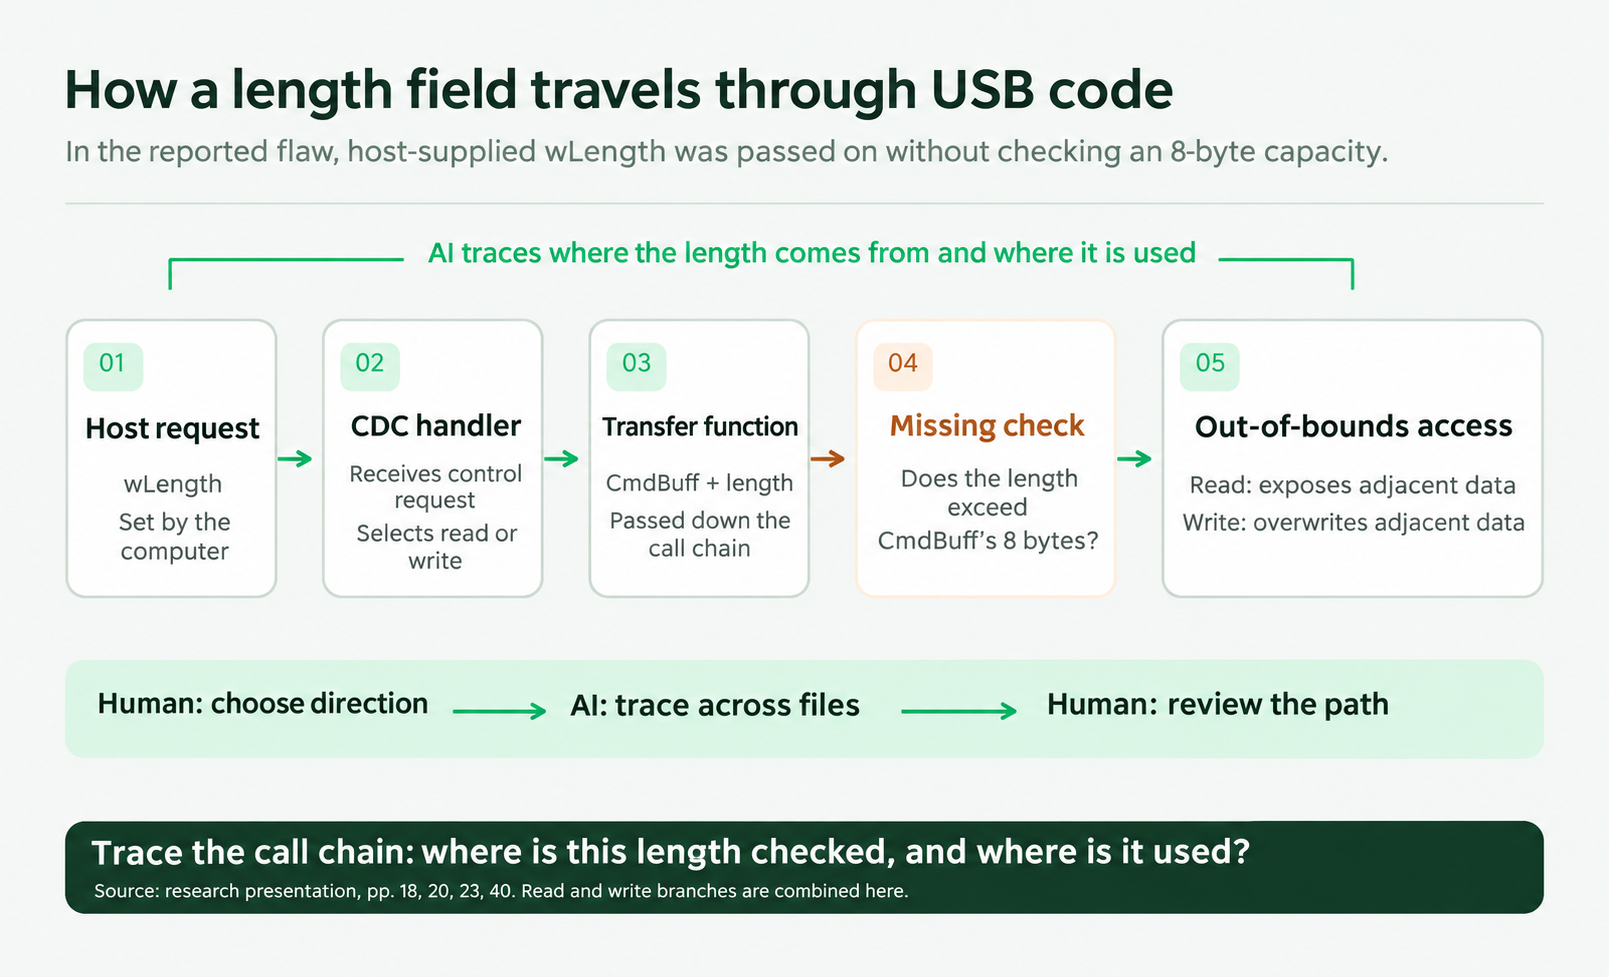
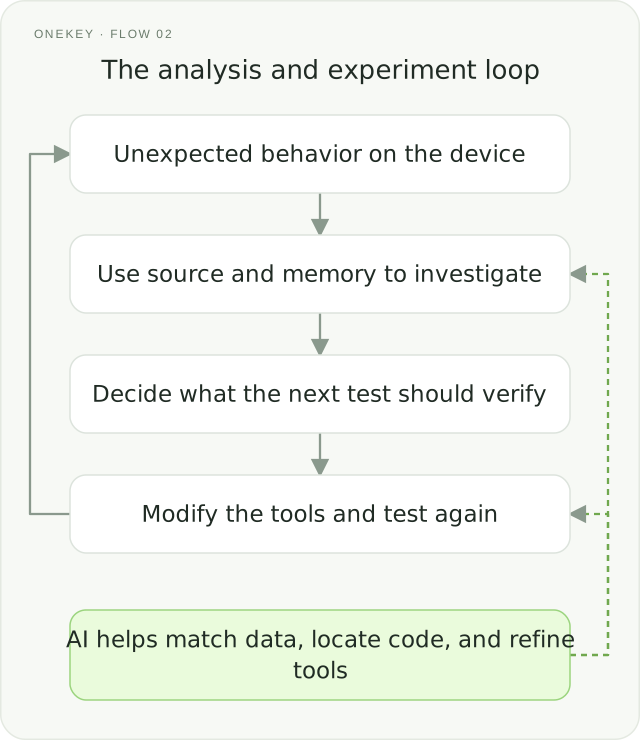
ИИ помогает упорядочить материал. Получив соответствующий код, он может проследить длину по графу вызовов, построить путь от входа до доступа к памяти и выделить подозрительные места. Затем исследователи проверяют ограничения и воспроизводимость предполагаемой ошибки.
Мы обнаружили запись за границы: устройство выделяло буфер на 8 байт, но недостаточно ограничивало поступающую извне длину, позволяя лишним данным попасть в соседнюю память. Ошибка находилась в стороннем USB-пакете, интегрированном в кошелёк.
Почему запись может выйти за эти 8 байт? Они занимают лишь небольшой участок памяти, рядом лежат другие данные. Процессор автоматически не знает размер массива, объявленного в исходном коде.
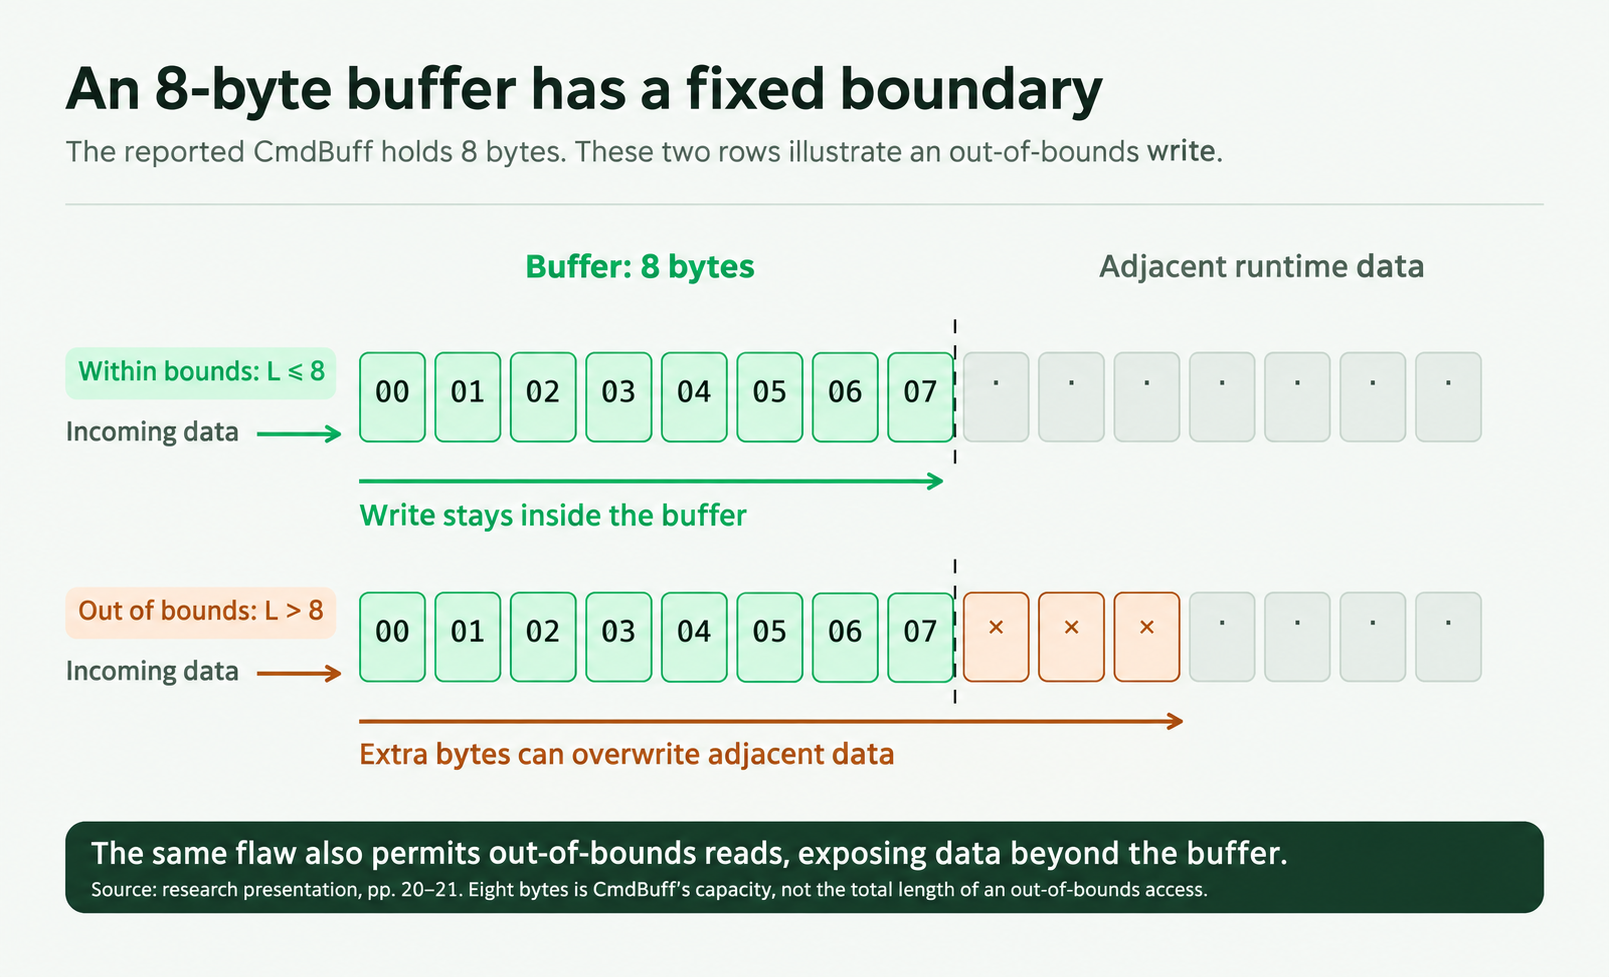
Буфер — область с начальным адресом и длиной. После пересечения границы обращение может продолжиться, если соседняя память доступна. Чтение за границей раскрывает соседние данные, запись — изменяет их. Обычное поле длины становится способом повлиять на внутреннее состояние устройства.
Пересечь границу — только первый шаг. Ещё нужно понять, какие данные поддерживают связь, какие влияют на исполнение и что даст каждое изменение. Войти в комнату — не значит разобраться во всех её механизмах.
2. Что позволяет сделать уязвимость?
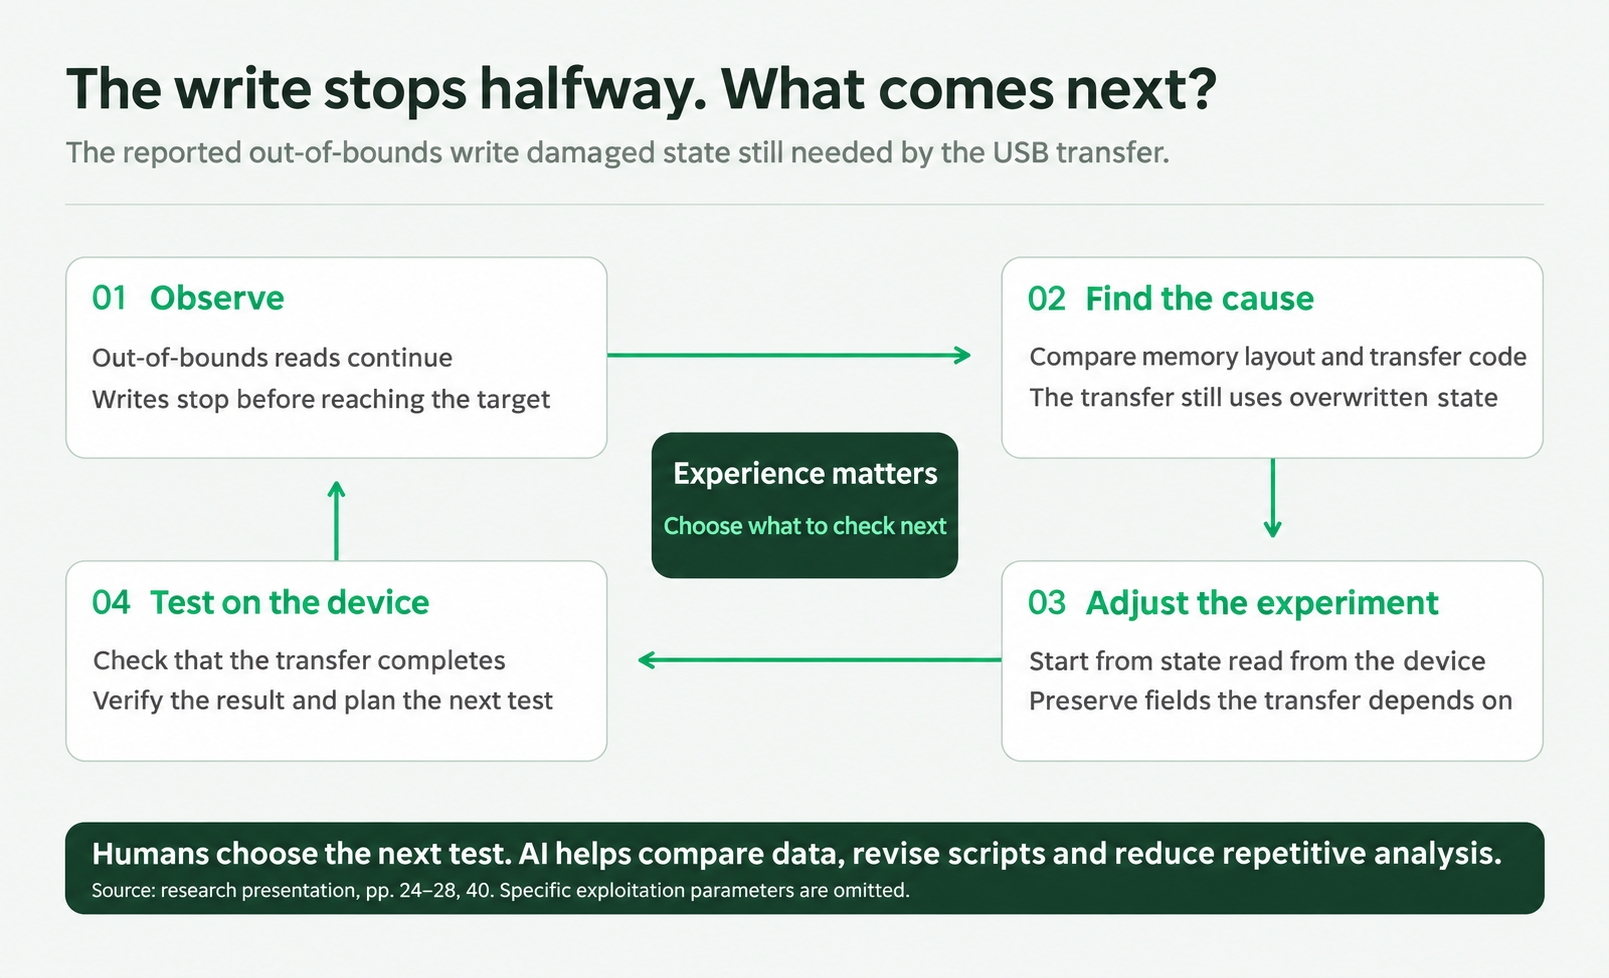
Мы начали проверять последствия. Первая запись сразу оборвала USB-соединение.
Это остановило дальнейший тест, но дало подсказку: рядом с буфером, вероятно, находилось состояние, необходимое для работы USB, и запись его повредила.
Данные программы занимают соседние адреса; точное размещение определяется компиляцией. За 8-байтовым buffer[8] могут находиться состояние соединения usb_state, длина приёма rx_len или указатель обратного вызова.
Представьте ряд шкафчиков. Разработчик даёт им имена, а процессор обращается к адресам. При последовательной записи 1000 байт он не остановится автоматически на границе каждой переменной. Нужные для работы данные тоже могут быть перезаписаны.
Чтобы USB оставался стабильным, нужно сохранить критическое состояние: менять области, не нарушающие работу, либо сохранять важные значения при записи через окружающую память.
Для точных изменений необходимо сопоставить исходный код с реальным расположением данных в памяти. Код описывает переменные и структуры, дамп обычно содержит адреса и значения. Соответствие приходится проверять поле за полем.
Это один из самых трудоёмких этапов, особенно зависимых от опыта. Позиции выводят из типов, размеров и выравнивания полей, затем сверяют с устройством. Ошибка в одном смещении сдвигает всё последующее. Новичку может быть трудно даже понять устройство структуры.
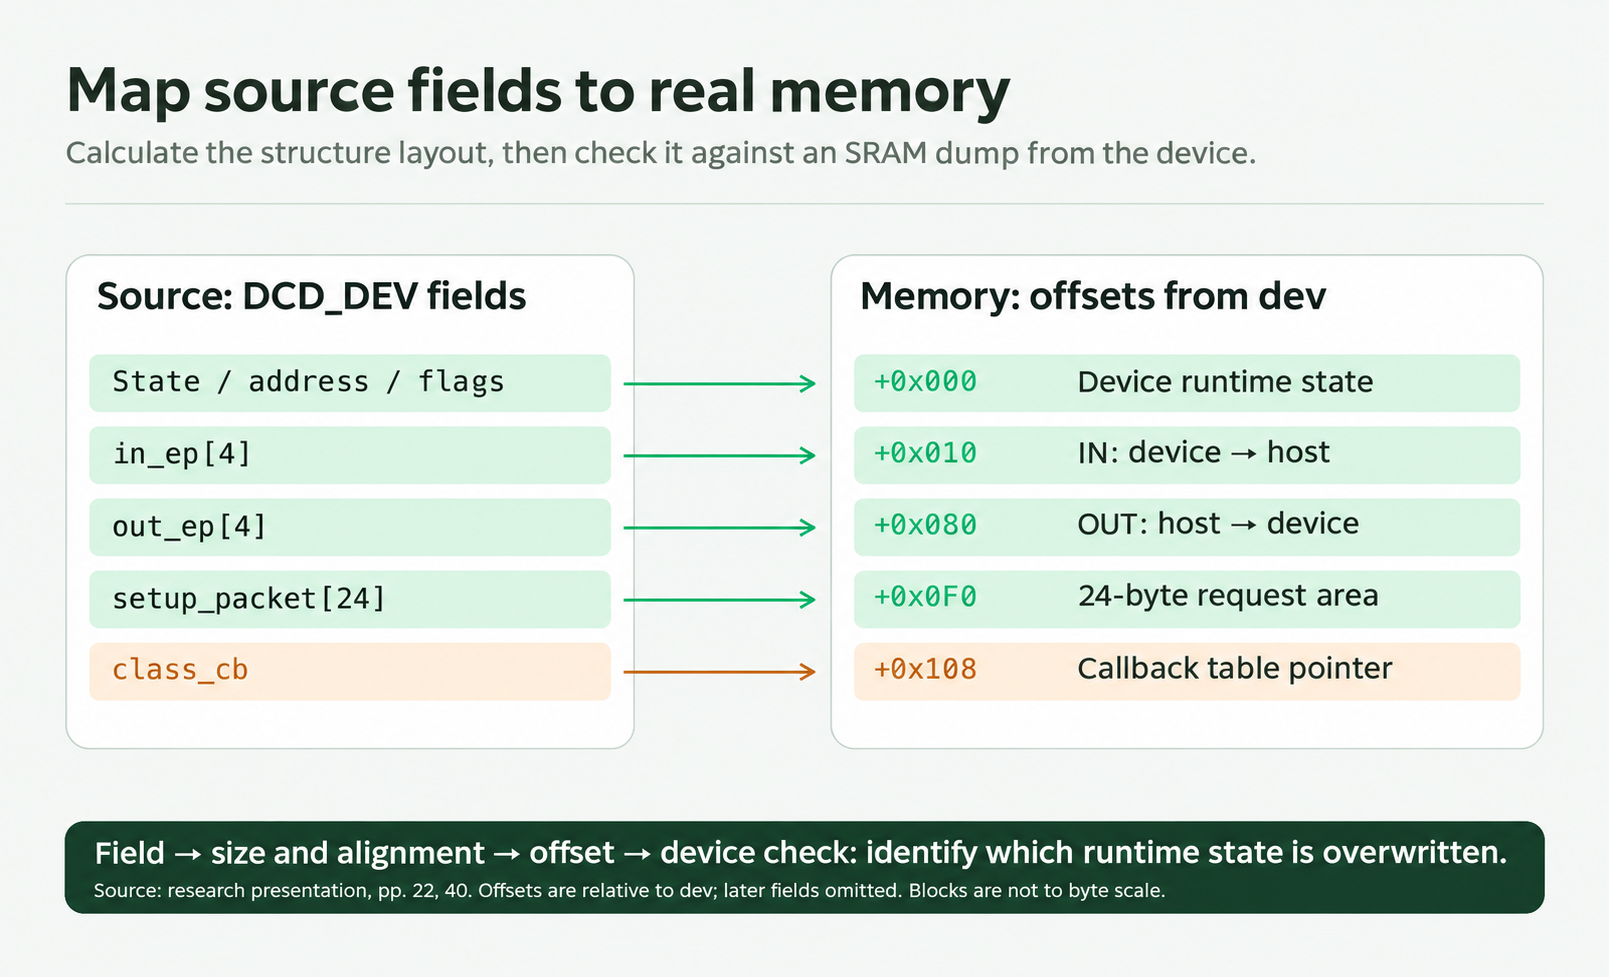
ИИ помогает с повторяющимися сопоставлениями. Исходный код — текст, память можно представить шестнадцатеричными данными, поэтому их удобно анализировать вместе. ИИ также помогает менять тестовые инструменты, а исследователь по результатам опытов определяет следующий шаг. Агент может связать анализ и вызовы инструментов, постепенно уточняя карту памяти.
После нескольких экспериментов мы нашли вариант записи, который менял целевую область, сохраняя необходимые для работы данные. Устройство оставалось подключённым.
Следующий шаг — направить исполнение к внедрённому коду. Естественная цель — указатель функции, определяющий, какая функция будет вызвана дальше. Подобно строке в программе мероприятий, его изменение может изменить дальнейший ход выполнения.
Обычно устройства защищаются от этого: механизмы защиты памяти могут разрешать запись в область и запрещать исполнение, а аппаратный блок контролирует права.
При правильной защите процессор не выполнит внедрённый код, даже если указатель направлен на него. В исследуемом устройстве была ошибка конфигурации блока защиты памяти MPU, оставлявшая возможность на этом этапе.
Если указатель можно изменить, а внедрённый код исполняется, атакующий получает выполнение кода на главном контроллере. Подпись прошивки проверяет подлинность кода при загрузке; изменения памяти во время работы требуют действенной защиты исполнения.
Приведёт ли контроль над главным контроллером к секретам восстановления кошелька, зависит от границ авторизации всей системы безопасности.
3. Почему контроль над MCU не раскрывает фразу сразу?
Очевидный следующий шаг — прочитать память и поискать фразу восстановления.
Аппаратные кошельки хранят данные восстановления зашифрованными, временно расшифровывают их для подписи или экспорта, а затем очищают. Чтение памяти не гарантирует открытый текст. Сначала нужно найти зашифрованные данные.
Подсказки есть в открытой прошивке. Анализ с ИИ позволяет определить страницы защищённого чипа: первые 16 байт Page 0 содержат IV, а Page 1 — шифротекст.
Теперь нужно сопоставить поля кода с данными устройства: какому адресу соответствует каждое поле, где IV и где шифротекст.
ИИ снова помогает в длительном сопоставлении и поиске нужных данных.
Получив шифротекст, можно выбрать два пути: взломать шифрование или воспользоваться процедурой расшифровки самого устройства.
Первый путь: взломать шифрование напрямую
Шифрование похоже на замок: с ключом запереть и открыть легко. Без ключа один шифротекст не должен существенно помогать.
Обозначим исходные данные E, шифротекст C, ключ шифрования K.
Их связь:
Шифрование E ключом K даёт C; расшифровка тем же ключом восстанавливает E. Здесь рассматривается попытка восстановить данные без K. Надёжный алгоритм должен делать это вычислительно непрактичным.
Как измерить такую надёжность? Криптография позволяет сформулировать вопрос точно.
Вы выбираете два открытых текста E₀ и E₁. Компьютер случайно выбирает один, шифрует ключом K и показывает C. Сможете определить, какой текст выбран?
Для безопасного шифрования должно выполняться условие:
Pr[верно] — вероятность угадать, ½ — вероятность успеха при случайном выборе. Вертикальные черты означают модуль разности вероятностей. Это передаёт идею семантической безопасности.
Вы выбираете два текста, получаете шифрование одного и всё равно не можете заметно превзойти случайную догадку. Даже 00000000 и 11111111 не должны оставлять полезного различимого следа в шифротексте. Главная идея: шифрование не должно подсказывать правильный ответ.
Два варианта упрощают объяснение: случайный успех равен ½. Для четырёх кандидатов это четверть, для большего числа — ещё меньше. Суть в том, что шифротекст не должен давать значимого преимущества перед угадыванием.
Если математического сокращения поиска нет, остаётся перебор ключей. Двоичный ключ из n бит имеет 2ⁿ значений. В среднем нужно проверить примерно половину пространства, то есть 2^(n−1) кандидатов. При r проверках в секунду:
Возьмём n = 256, как у AES-256, и r = 10¹⁵: гипотетический миллион машин, каждая проверяет миллиард ключей в секунду. Даже при такой огромной скорости t составляет около 2×10⁵⁴ лет.
Возраст Вселенной — примерно 1,4×10¹⁰ лет, разница около 10⁴⁴ раз. Идеализированный квантовый поиск Гровера уменьшает сложность до квадратного корня, примерно до поиска по 128-битному пространству. При том же упрощённом предположении о скорости это всё ещё более 10¹⁵ лет. Это иллюстрация, а не прогноз производительности реального квантового оборудования.
Такая стоимость делает прямой перебор непрактичным. Проверенные алгоритмы проходят многолетний криптографический анализ; действенный взлом стал бы крупным результатом. Поэтому мы вернулись к реализации устройства.
Нужно выяснить, какие код, учётные данные и материалы используются при расшифровке и может ли скомпрометированный контроллер повторить этот путь.
Второй путь: повторить штатную расшифровку
Если устройству нужна расшифровка для подписи, в прошивке должен быть путь получения нужного ключа. Настоящей целью становится код восстановления ключа.
Проследив этот код с помощью ИИ, мы нашли следующую связь:
После проверки учётных данных чип A выполняет внутри два этапа KDF и три операции SHA-256, формируя 32-байтовую долю A. Чип B применяет XOR к защищённой странице хранения и дайджесту, полученному из PIN-кода, формируя 32-байтовую долю B. Доли объединяются в 64 байта, проходят хеширование с солью и SHA-512; первые 32 байта служат ключевым материалом. Затем он объединяется с 32-байтовым AES-ключом из OTP для получения итогового ключа расшифровки. Третий защищённый чип в основном отвечает за аутентификацию, например отпечатки, и не выполняет ту же роль в этой схеме.
Представьте сейф с тремя замками: для открытия нужны все три ключа. Это материалы защищённого чипа A, чипа B и OTP.
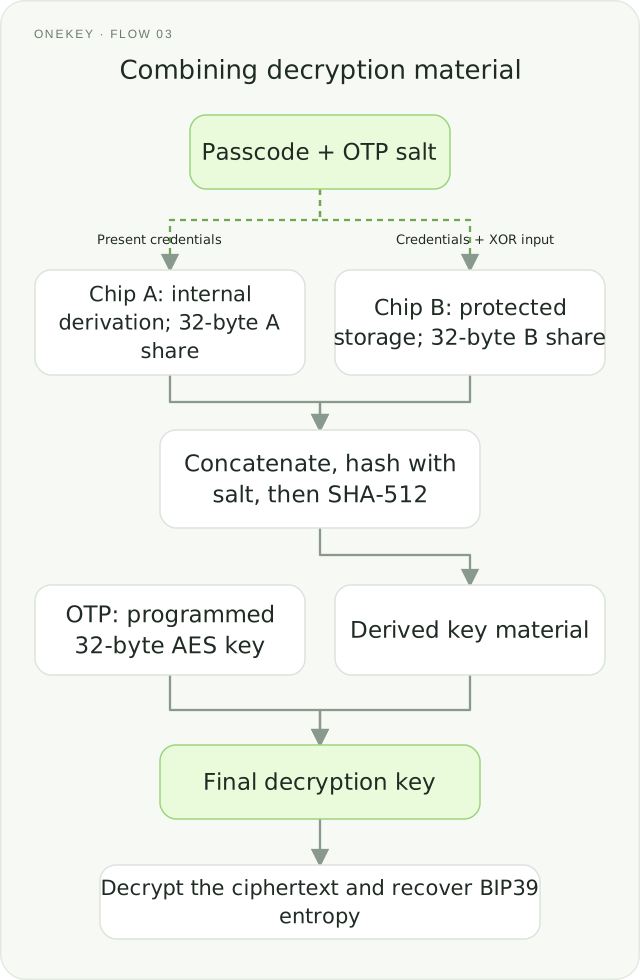
Здесь пароль означает PIN устройства. Соль и AES-ключ — отдельные случайные значения для каждого устройства, записываемые при производстве в однократно программируемую память OTP. После записи их нельзя изменить, но чтение может оставаться возможным. Функция f на контроллере использует эти материалы. Если контроллер захвачен и все данные доступны, атакующий может попытаться повторить восстановление.
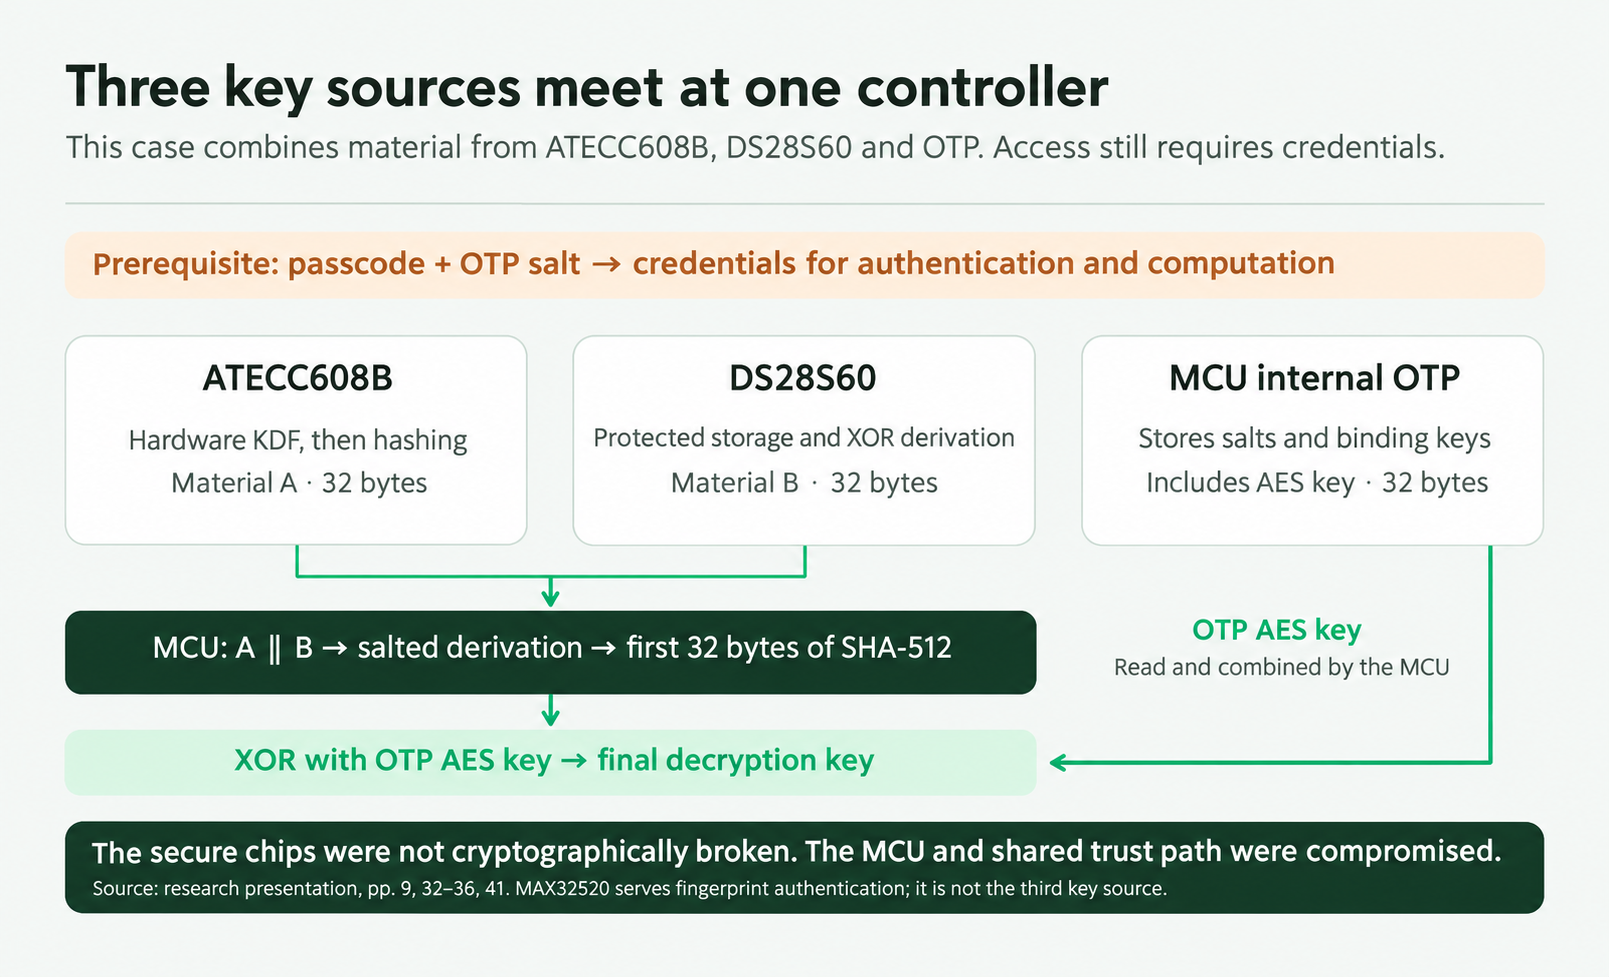
Как получить эти материалы?
Начнём с соли и AES-ключа в OTP. На этом устройстве права чтения контролирует MPU, который главный контроллер может перенастроить. Поэтому контроль над MCU создаёт возможность изменить права и прочитать данные.
Помимо OTP нужен ещё PIN-код.
4. Что происходит с ограничением попыток PIN?
Этот раздел объясняет, почему после получения проверочных данных в условиях эксперимента офлайн-проверка не зависит от счётчика ошибок устройства. Он не отменяет исходных требований разблокировки и разрешения USB: официальное сообщение требует знания правильного PIN-кода.
Даже если доступ уже требует авторизации, аудит должен проверить, может ли захваченный MCU экспортировать проверочные данные и остаётся ли после этого действенным лимит попыток.
PIN состоит из шести цифр; после пяти неверных попыток устройство настроено на стирание данных. Как оценить этот предел?
Мы попросили ИИ найти процедуру проверки PIN и установить, как именно устройство проверяет введённое значение.
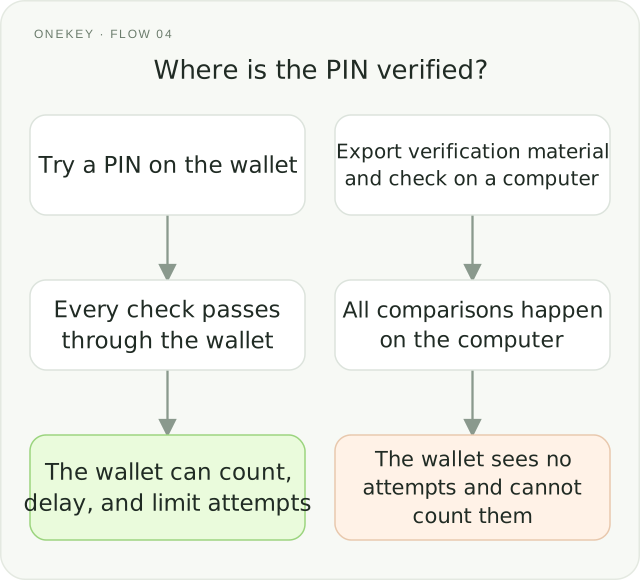
Обычно хранится проверочное значение, а не PIN открытым текстом: v = F(p, s). Здесь p — PIN, s — индивидуальные данные устройства, F — вычисление из прошивки. В этом случае вычисление выполняется на главном контроллере. Даже если p неизвестен, в условиях эксперимента можно прочитать v, F и s.
Тогда проверку можно воспроизвести вне устройства. Вычисления, не проходящие через кошелёк, не увеличивают его счётчик ошибок. Кандидаты PIN можно проверять полностью на компьютере.
Проект предполагает, что главный контроллер остаётся доверенным. У чипа B разные условия доступа к разным данным: проверочное значение читается до проверки, а доля B для расшифровки защищена строже. В штатной работе контроллер считает ошибки и запускает стирание после пяти попыток.
При офлайн-проверке 10⁶ комбинаций шестизначного PIN становятся конечным пространством поиска вне контроля устройства. В одном эксперименте PIN был найден за 1,831 секунды. Ниже объясняется, что этот результат позволяет и не позволяет сказать о стоимости одной проверки.
Когда PIN доступен, есть последний необходимый вход. Алгоритмы прошивки позволяют получить учётные данные для дальнейшей процедуры.
При наличии всех материалов можно восстановить фразу и потенциально получить контроль над соответствующими счетами.
5. Как выглядит риск для пользователя?
До сих пор мы следовали за исследователем. Теперь посмотрим с позиции владельца кошелька.
Сценарий первый: старая прошивка и разрешённый USB
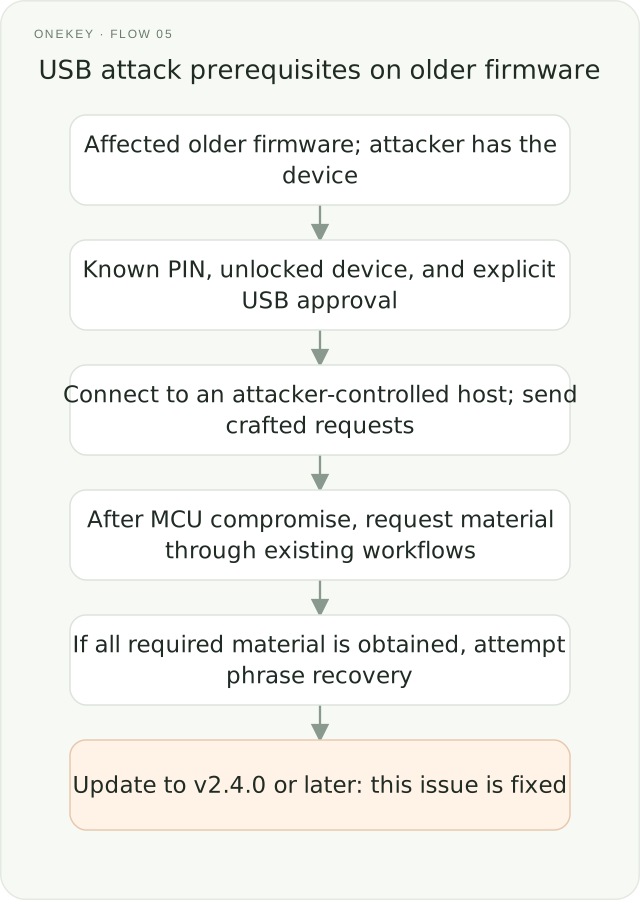
Сначала нужно проверить, относится ли прошивка к затронутым старым версиям и выполняются ли все условия сообщения. Одно лишь вредоносное ПО на компьютере не доказывает возможность напрямую взломать заблокированный кошелёк.
Этот USB-путь требует разблокированного устройства, разрешённого соединения и компьютера под контролем атакующего. Простое подключение зарядного кабеля этим условиям не отвечает.
Только после выполнения условий вредоносный компьютер получает доступ к уязвимой обработке USB-запросов.
Исследование показывает именно условный путь: компьютер отправляет специально сформированный запрос, воздействует на MCU и через штатные процедуры получает необходимые материалы.
Если удаётся собрать всё для восстановления фразы, соответствующие активы могут оказаться под угрозой. Результат нельзя переносить на все версии прошивок, режимы использования и аппаратные кошельки.
Сценарий второй: физический доступ к устройству
Физический доступ открывает другие направления исследований. Далее описаны общие принципы физических атак, а не методы, продемонстрированные в этом случае. Само обладание устройством не означает обход PIN.
Вскрытие, подключение щупов и инъекции сбоев помогают исследовать границы защиты MCU. Процессоры зависят от питания и тактовых сигналов. На некоторых устройствах в определённых условиях кратковременное нарушение этих сигналов может повлиять на проверку безопасности. Успех зависит от чипа, настроек и защиты.
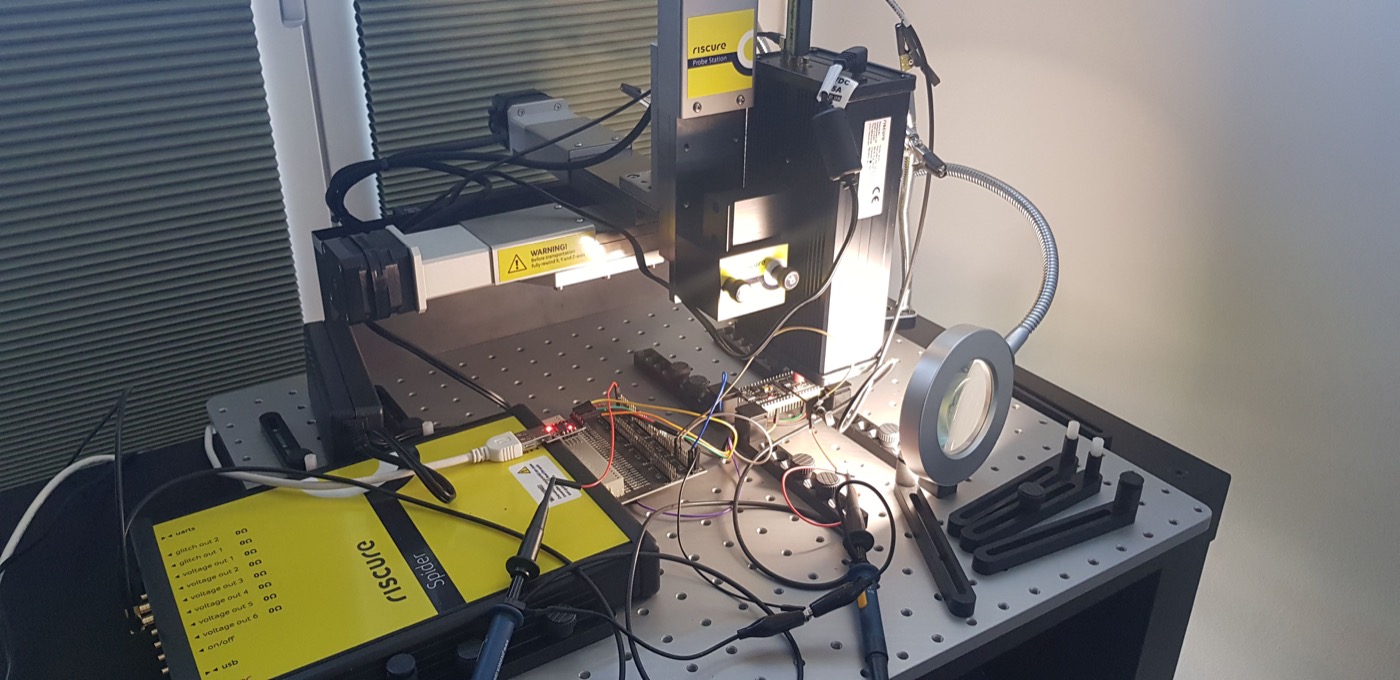
Даже после захвата MCU дальнейший доступ зависит от учётных данных, авторизации защищённых чипов и других независимых механизмов.
Пример напоминает: защитные функции нужно оценивать как целостную систему. Связав несколько ошибок реализации с помощью ИИ, атакующий может постепенно пересечь задуманные границы.
4. Каков вклад ИИ?
Если соединить этапы, получится следующая цепочка:
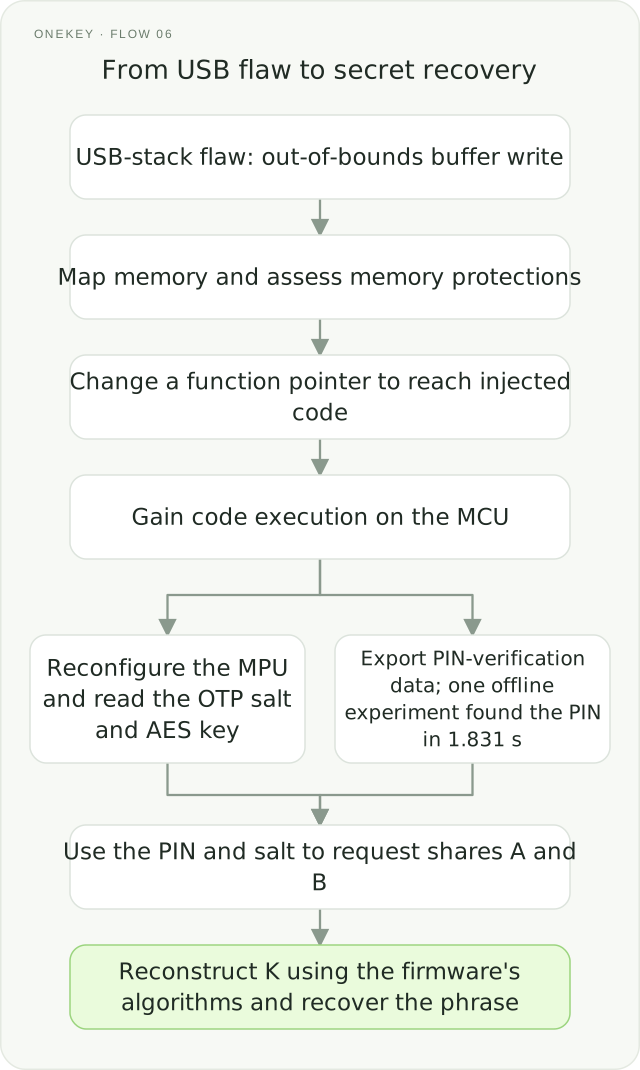
В этом исследовании ИИ в основном помогал анализировать уязвимость, менять инструменты, искать код и сопоставлять данные. Исследователи выбирали подход и направление; ИИ взял на себя большую часть кропотливой работы, требующей опыта, поддерживая темп анализа и проверки.
Для новичков во встраиваемых системах главным препятствием часто становится понимание кода и поведения при отладке. ИИ объясняет код, упорядочивает подсказки и помогает проверять гипотезы, позволяя пройти этапы, на которых раньше работа останавливалась.
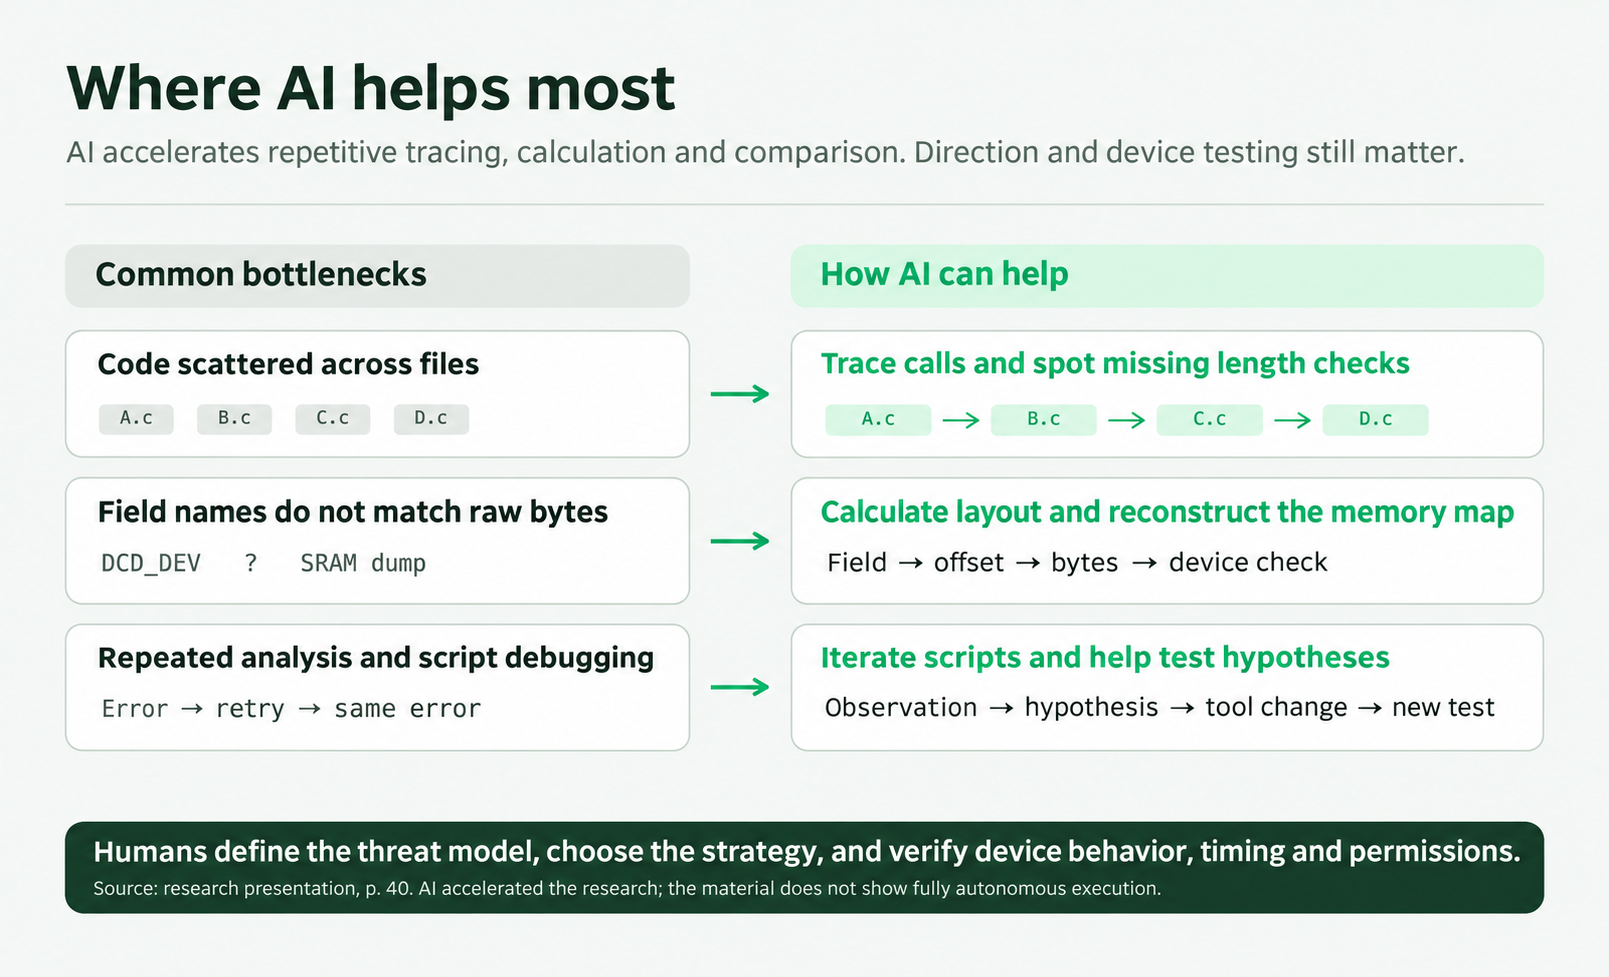
Понятная аналогия — создание сайтов. Раньше человеку без навыков программирования требовалось много времени; сегодня запрос на обычном языке может дать готовую страницу. Мошенники используют это для имитации банков и сервисов: фишинговые страницы проще создавать и сложнее отличать.
ИИ осваивает и другие части рабочего процесса.
Облачные инструменты ИИ обычно имеют ограничения безопасности. Инструменты без сопоставимых ограничений могут применяться к более широкому кругу атак. В сочетании с лабораторными источниками питания, щупами и оборудованием инъекции сбоев ИИ также помогает писать управляющий код и систематизировать измерения.
Конкретный пример Raelize опубликовала в мае 2026 года. Исследователи собрали аппаратуру, передали схемы подключения и справочные материалы, а Claude Code помог написать программы управления оборудованием инъекции сбоев и лабораторным источником питания. Эксперимент воспроизвёл известный обход защищённой загрузки на раннем ESP32. Отчёт Raelize
Защищённая загрузка проверяет подлинность прошивки до исполнения. Код проверки предполагает правильное выполнение инструкций процессором. Реальные чипы зависят от напряжения и тактовых сигналов. Инъекция сбоев кратко нарушает эти условия, например импульсом напряжения, вызывая ошибочное действие, которое может обойти проверку.
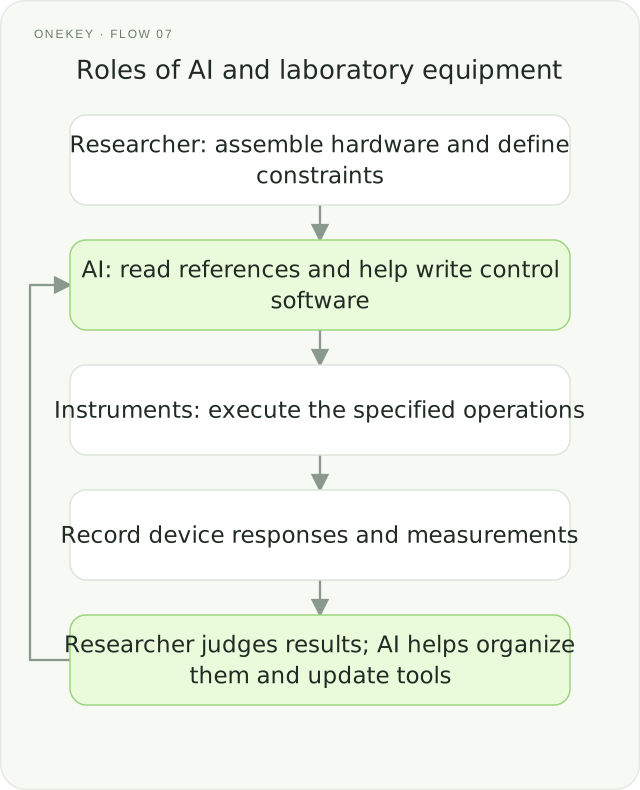
От чтения кода до экспериментов ИИ связывает разрозненные сведения и снижает нагрузку по их обработке. Это полезно и для анализа атак, и для защиты.
Поэтому аппаратная и программная безопасность остаются ключевыми в эпоху ИИ. Работа NVIDIA над аппаратной изоляцией исполнения и границами разрешений в ИИ-инфраструктуре опирается на общий принцип, близкий к изоляции чувствительных операций в кошельке. NVIDIA Sentry, архитектура безопасности агентов, анонс DSX POD. Снижение стоимости анализа и автоматизации требует постоянного развития сетевой и аппаратной защиты.
5. Безопасность цепочки поставок тоже важна
Исследование выявляет часто упускаемый компонент: уязвимый USB-код пришёл из SDK производителя чипа. Поэтому аудит должен охватывать логику кошелька, низкоуровневые драйверы, коммуникационные стеки, их настройки и взаимодействие в устройстве.
У банковских и защитных токенов, платёжных терминалов похожее разделение ролей. ПО обрабатывает внешние запросы и передаёт задачи компонентам, хранящим секреты и выполняющим защищённые операции. Активы различаются, механизмы имеют общие черты. Стандарты PCI для платёжных терминалов
Низкоуровневые компоненты часто используются в разных продуктах. Один SDK производителя чипа становится основой нескольких устройств. Поэтому ошибка общего кода может распространять последствия через цепочку поставок.
Производителю нельзя ограничиваться собственным прикладным кодом. Пользователь покупает целое устройство независимо от автора уязвимого компонента. Даже правильную логику кошелька может подорвать драйвер. За оценку безопасности всей системы отвечает производитель устройства.
Исправление также требует координации: поставщик чипа исправляет SDK, производители определяют затронутые продукты, адаптируют и тестируют прошивку, пользователи устанавливают обновления. Этот случай исправлен в v2.4.0; владельцам затронутых старых версий следует обновиться через официальные каналы. Привязка риска к конкретным версиям не даёт принять историческое исследование за текущее состояние продукта.
В эпоху ИИ безопасность должна охватывать весь жизненный цикл: проектирование аппаратуры и ПО, подлинность упаковки, коммуникации, эксплуатацию и ремонт. На каждом этапе нужны соответствующие знания и проверки.
Команда OneKey Anzen также учитывает результаты в собственных разработках. ИИ помогает атакующим собирать подсказки и одновременно помогает нам проверять код и предположения.
Наглядное приложение: как случайные данные превращаются в 24 слова
Фраза восстановления позволяет восстановить кошелёк. Рассмотрим превращение случайных битов в двадцать четыре слова.
В 24-словном формате BIP39 исходные данные содержат 256 бит. Каждый равен 0 или 1, всего 2²⁵⁶ комбинаций. Из данных вычисляются 8 бит контрольной суммы; после добавления получается 264 бита.
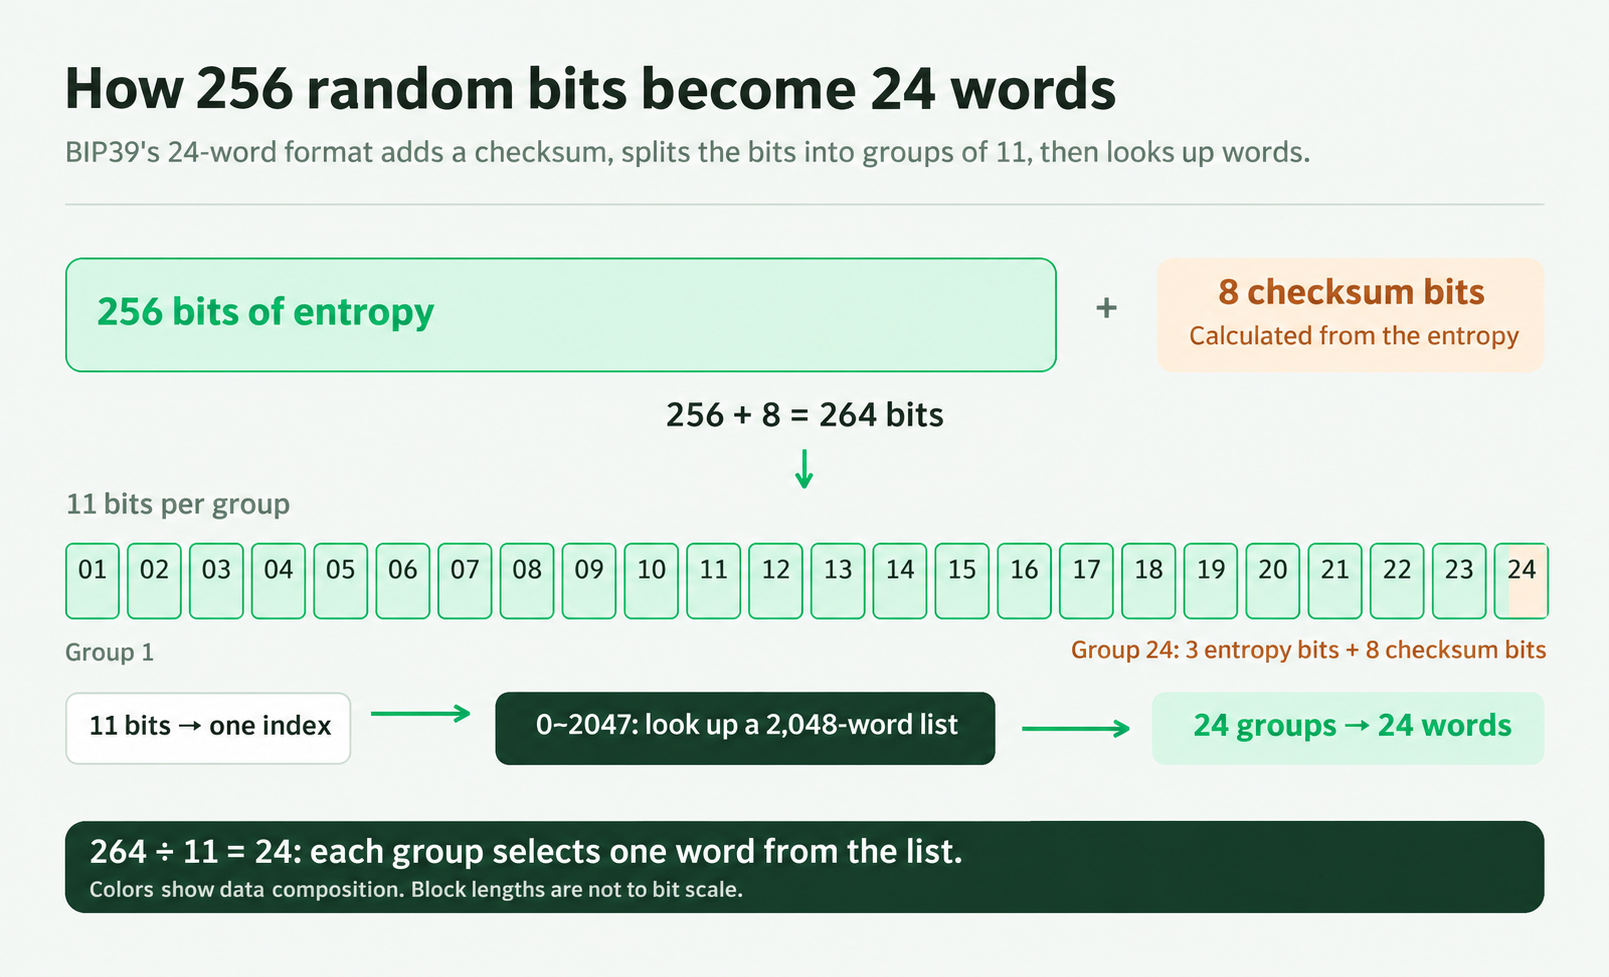
Результат делится на группы по 11 бит. Каждая задаёт один из 2¹¹ = 2048 индексов в списке из 2048 слов. Поскольку 264 ÷ 11 = 24, получается двадцать четыре слова.
256 + 8 = 264 = 24 × 11.
Последние 8 бит вычислены из исходных данных. Они не добавляют случайности и не усложняют угадывание. Их задача — обнаружить некоторые ошибки записи; это не шифрование. Словарь лишь сопоставляет индексы со словами и может быть открытым.
Мнемоническая фраза и необязательная отдельная парольная фраза формируют seed, из которого по правилам вроде BIP32 выводятся ключи счетов. Одинаковые фразы и правила деривации восстанавливают тот же счёт. Спецификация BIP39, спецификация BIP32
Подробнее
1. Разделение секрета и независимая авторизация
Разделить секрет — не значит автоматически независимо контролировать доступ к долям. Если одна скомпрометированная сторона может запросить все доли, само разделение не создаёт для неё дополнительного вычислительного барьера.
Рассмотрим схему XOR с двумя долями. Секрет обозначим , маску выберем равномерно из , независимо от . Определим доли:
Здесь означает побитовое XOR.
Одна доля не раскрывает информацию о . Для любых фиксированных значений секрета и доли :
Правая часть не зависит от , поэтому условное распределение не зависит от . Наблюдение не меняет представления о . Аналогично, , а независимо от , поэтому ничего не сообщает о . Это требует равномерной независимой маски, которая не используется повторно для разных секретов.
Вместе доли восстанавливают секрет, поскольку повторное XOR сокращается:
Схема корректна: одна доля не даёт информации о секрете, а обе вместе однозначно его восстанавливают.
Здесь различаются два условия безопасности. Разделение защищает при утрате одной доли, но не автоматически при захвате пути запросов. Если контроллер после компрометации остаётся авторизованным заявителем, а другие чипы возвращают доли, атакующий собирает данные по штатному протоколу без криптоанализа. Вопрос проектирования — есть ли у каждой доли условия доступа, независимые от MCU. Захват MCU не должен автоматически разрешать доступ ко всем компонентам.
2. Время офлайн-поиска PIN и роль соли
Шестизначный десятичный PIN имеет кандидатов. Если каждая проверка проходит через устройство, счётчик ошибок, задержки и стирание могут сделать перебор непрактичным. После экспорта проверочных данных и воспроизведения вычисления на компьютере устройство перестаёт контролировать число попыток. В упрощённой модели стоимость зависит от числа кандидатов и времени проверки .
Пусть PIN распределён равномерно, а кандидаты проверяются без повторений. Правильный PIN с равной вероятностью занимает любую позицию из , поэтому ожидаемое число попыток равно
Соответствующее ожидаемое время — .
Указанные секунды нельзя просто разделить на . Поиск прекращается при нахождении PIN: время охватывает первые кандидатов, не обязательно всё пространство. Если правильный PIN занимает позицию , время одной проверки равно
Только при получается секунды. При любом величина строго больше. Поэтому — нижняя граница времени проверки. Время полного перебора также не меньше секунды.
Например, при последовательном поиске от и PIN получаем и . Проверка всех кандидатов занимает примерно секунды, ожидаемый поиск — около секунды. Числа зависят от , но вывод сохраняется: в условиях этого эксперимента офлайн-проверка без лимита попыток делает пространство из кандидатов перебираемым на обычном оборудовании.
Соль делает проверочные значения одного PIN разными на разных устройствах и мешает повторно использовать заранее рассчитанную таблицу. Она меняет распределённые затраты между целями, а не увеличивает пространство одного устройства. Когда необходимые данные конкретного устройства доступны, пространство остаётся , а стоимость проверки — .
Заключение
ИИ берёт на себя значительную часть самого изнурительного анализа и экспериментальной работы, требующих опыта. Прослеживание кода, сопоставление памяти, поиск ошибок и доработка инструментов идут быстрее. Исследователи по-прежнему выбирают направление и проверяют результат, а ИИ сокращает усилия и время для воплощения идеи. Именно здесь порог входа в атаки снижается на практике.
Те же возможности помогают защите: эффективнее проверять код, подтверждать уязвимости и анализировать цепочку поставок. Понимание этой роли ИИ позволяет точнее оценивать риски и усиливать нужные механизмы защиты.
Часто задаваемые вопросы
ИИ помогает читать прошивку, прослеживать параметры по цепочкам вызовов, сопоставлять структуры с памятью, упорядочивать результаты и менять тестовые инструменты. Цели, условия, методы проверки и оценка достоверности остаются за исследователями.
Описанный путь использует слабости реализации и авторизации, чтобы получить данные для расшифровки, а не взломать AES. ИИ в основном помогает анализировать код и данные. Исследование не демонстрирует взлом современной криптографии.
Самого количества недостаточно. Разделение секретов требует независимой авторизации. Если несколько чипов безусловно доверяют одному захваченному MCU, тот может собрать доли через штатные процедуры.
Устройство считает только проверки, проходящие через него. Если проверочные данные можно экспортировать, а вычисление воспроизвести отдельно, такие попытки до устройства не доходят. Риск зависит от прав экспорта, способа проверки и архитектуры авторизации.
Кошельки часто используют драйверы и стеки связи производителей чипов. Общая ошибка может затронуть несколько продуктов. Производителям нужно оценивать всю систему и координировать исправления SDK, адаптацию прошивки, тестирование и обновления пользователей.